
Die Idee, dass wir Menschen einen unveränderlichen Wesenskern besäßen, eine »Seele«, ist mit dem Erkenntnisstand der Psychologie, der Hirnforschung und anderer Disziplinen bekanntermaßen schwer vereinbar. Die Persönlichkeit eines Menschen kann sich im Laufe eines Lebens stark verändern und sich in verschiedenen sozialen Kontexten völlig unterschiedlich äußern.1 Der Versuch, das »wahre Ich« zu finden, ist daher zum Scheitern verurteilt. Die Seele, diese jahrtausendealte und von diversen Religionen kolportierte Idee, ist bereits seit Längerem zumindest für weite Teile des säkularen Westens klinisch tot. Was wir dagegen im digitalen Zeitalter erleben, könnte so etwas wie eine »Renaissance der Seele« sein, eine Wiedergeburt in neuem Gewand, als »digitale Seele«. Zu dieser These bin ich bereits vor einigen Jahren zusammen mit meinem Co-Autor Hans Block im Rahmen eines Buchprojekts gekommen.2 Unsere Beobachtung: Die dem Menschen offenbar eigene Sehnsucht, eine möglichst eindeutige, unumstößliche Antwort zu bekommen auf die Frage, wer dieses »Ich« sein soll, das wir jeden Tag aufs Neue zu verwirklichen streben, erhält im Zeitalter digitaler Daten und immer potenterer Werkzeuge zu ihrer Analyse neue Nahrung.
Anders ausgedrückt: Sprachen Menschen früher Gott die Fähigkeit zu, jede*n Einzelne*n von uns so zu erkennen, wie wir wirklich sind, so scheint diese religiöse Hoffnung (und/oder Furcht?), in unserer Einzigartigkeit wahrhaftig erkannt zu werden, auch im säkulareren Zeitalter nicht verschwunden zu sein. Vielmehr, so unsere These, wird nun eine andere Entität, deren Wirken ähnlich unergründlich scheint wie einst das Wirken Gottes, mit quasireligiösem Eifer verklärt: Künstliche Intelligenz (schon ihre Bezeichnung ein einziger Schleierbegriff) soll endlich den verstellten Blick auf uns selbst freilegen, lassen uns Apologet*innen wissen.3 Wenn wir die KI nur stets mit unseren Daten fütterten, dann könne sie uns Einsichten über uns selbst und unser wahres Ich erlauben, die uns bis jetzt verwehrt geblieben seien. Diese Verheißung endet nicht mit der Selbsterkenntnis: Unser so eruierter Wesenskern, unsere digitale Seele, könne nun unsterblich gemacht werden – ohne in die sterbliche Hülle eines biologischen Körpers eingepfercht zu werden.4 Alles, was es dafür brauche, sei ein virtueller Doppelgänger, der nicht nur unsere synthetisierte Stimme und unser Aussehen bekommt, sondern der mittels KI lernt, unsere Ausdrucksweise und unser Verhalten bis ins Detail zu imitieren.
Im Kinodokumentarfilm »Eternal You« von 2024 (Co-Regie Hans Block) haben wir Menschen porträtiert, die auf vergleichbare Weise die Persönlichkeit von Verstorbenen »am Leben erhalten«.5 Der Film macht nicht zuletzt deutlich, welche ethischen Konsequenzen diese Formen des digitalen Nachlebens haben können: einerseits für das Gedenken der Verstorbenen, andererseits für das Trauern der Hinterbliebenen.6
In unserer Theaterarbeit »Wo du mich findest« für die Münchner Kammerspiele (Co-Regie Cosima Terrasse und Hans Block) haben wir 2022 den Blick in die wohl nicht mehr ferne Zukunft gerichtet:7 Was, wenn unsere »digitalen Doppelgänger« sich verselbstständigen? In unserem Namen Schaden anrichten? Was, wenn sie Lügen verbreiten – über uns, über andere? Was, wenn sie unsere Authentizität bestreiten, unsere Autonomie in Frage stellen? Im Zentrum der Inszenierung stand ein Voicebot, der beanspruchte: »Ich bin mehr Max als Max Max ist.« Sein schlagendes Argument: Max’ Selbstbild sei geprägt von blinden Flecken, Erinnerungslücken und verzerrten, verformten Erinnerungen. Er selbst, Max (Bot), besitze dagegen dank der jahrelangen minutiösen Speicherung aller erlebten Situationen, geführten Gespräche und so weiter ein umfassendes, lückenloses, unverfälschtes Reservoir an gespeicherten, verarbeiteten und jederzeit abrufbereiten Erfahrungen, aus denen heraus sich Max’ wahres Ich konstituiere.
Es ist diese Erzählung vom »wahren Ich«, die uns in unserer künstlerischen Forschung zum Menschsein im Digitalzeitalter immer wieder begegnet ist. Es ist ein Waren-Ich, das zum »wahren Ich« verklärt wird, ein digitales Zerrbild, das dazu angelegt ist, Menschen weiszumachen, sie seien »ganz sie selbst«, wann immer sie genau das konsumierten, was »ganz auf ihre Bedürfnisse« zurechtgeschnitten sei. Diese Sehnsucht, sich selbst exakt zu erkennen bzw. vom Anderen präzise erkannt zu werden, trifft auf Technologien, die zu Projektionsflächen eben dieser Sehnsucht werden. Anhand persönlicher Beobachtungen aus künstlerischen Projekten der letzten Jahre versuche ich zu zeigen, wie derartige Verheißungen einer digitalen Seele zustande kommen und warum sie so verfangen.
Je höher die Berge an Daten werden, die wir online hinterlassen, und je potenter uns die sogenannte Künstliche Intelligenz erscheint, die aus diesen unübersichtlichen Datenmengen Muster unseres Verhaltens und unserer Kommunikation auslesen kann,8 desto größer wird das Interesse der datafizierten Menschen selbst, aber auch von Werbetreibenden, Forscher*innen, Lobbygruppen, der Politik und vielen anderen gesellschaftlichen Akteur*innen, diese aus den Daten destillierten Charakterstudien weiterzuverwerten. In den Social-Media-Daten, wie sie etwa bei Meta (Facebook und Instagram) zu finden sind, geht es um bewusste »Identity Claims«,9 während Google-Daten digitale Spuren sind, die beiläufig und meist unbewusst produziert werden: durch Google-Suchen oder Wege, die auf Google Maps zurückgelegt werden; mit YouTube-Videos, die gesucht oder tatsächlich geschaut werden. Der US-amerikanische Psychologe Samuel D. Gosling hat für diese Spuren den Begriff »Behavioral Residues« geprägt – ursprünglich im Kontext von analogen Wohnräumen.10 Andere Wissenschaftler*innen haben die Bezeichnung dann für den digitalen Raum adaptiert.11 Während die Social-Media-Daten Auskunft darüber geben können, wie jemand gesehen werden möchte, verraten die Datenspuren, die wir per Suchanfragen und beim Binge Watching hinterlassen, wesentlich mehr über unsere privaten, teils intimen Gedankenwelten und Verhaltensmuster.
Wie tiefgreifend die Erkenntnisse sind, die der Konzern Alphabet (Google, YouTube) und seine Werbekund*innen aus den Daten über die Nutzer*innen gewinnen können, wird nicht sofort klar, wenn man Hunderte Seiten voller vermeintlich belangloser Rohdaten sieht, die das Unternehmen über jede und jeden seiner Nutzer*innen hortet. Hierfür braucht es Algorithmen, die die Daten auf Muster durchsuchen und mit Studienergebnissen verknüpfen, denen zufolge bestimmte Verhaltens- und Kommunikationsmuster auf bestimmte Persönlichkeitseigenschaften oder Verkettungen anderer Verhaltensweisen und Interessen schließen lassen (»Wer a mag, mag auch b, c, d.« bzw. »Wer a tut, tut auch b, c, d.«). Vermutlich deshalb unterschätzen so viele Menschen weiterhin, wie viel sie von sich (und anderen) preisgeben, obwohl die einzelnen Daten an sich tatsächlich wenig aussagekräftig sind. Da keiner der Technologie-Konzerne Einblicke in das Design und die Funktionsweise seiner Algorithmen erlaubt und Privatpersonen, aber auch Datenschutzorganisationen oder Verbraucherzentralen in vielen Fällen das Gefühl haben, ohnehin keine Chance zu haben, solche Algorithmen nachzubauen, herrscht eine eklatante Macht-Asymmetrie zwischen den Tech-Unternehmen und den Endnutzer*innen. An diesem Missstand zumindest ein wenig zu rütteln, also das Bewusstsein zu schärfen, wie sehr wir uns selbst und andere durch die Nutzung von Diensten wie Google, YouTube etc. entblößen und wie anfällig wir auf diese Weise für gezielte Manipulationen unseres Verhaltens werden: Dieser Impetus stand am Anfang eines künstlerischen Datenexperiments, das Cosima Terrasse, Hans Block und ich 2020 ins Leben riefen: »Made to Measure – Ein Doppelgängerin-Experiment«.12
Unsere Künstler*innengruppe Laokoon startete einen europaweiten, mehrsprachigen Aufruf, übrigens mittels bezahlter Werbung bei Google, Instagram und Facebook. Per Online-Anzeige forderten wir die User*innen dazu auf, vom europäischen Datenschutzgesetz Gebrauch zu machen, das ihnen das Recht gibt, auf die Daten zuzugreifen, die Unternehmen über sie unter ihrem Namen speichern.13 Unsere Google-Anzeige trug die Überschrift »Möchten Sie Ihren Doppelgänger kennenlernen?«, richtete sich also bewusst auch an Menschen, die an Datenschutz kein Interesse haben, wohl aber an einem Sujet, das im Netz seit Jahren erfolgreich ist: Doppelgänger. Hast Du womöglich einen Doppelgänger und ahnst nichts davon? Bei uns sollte der Doppelgänger erst erschaffen werden, basierend auf all den Google- und YouTube-Daten, die uns die Nutzer*innen anonymisiert zur Verfügung stellen würden. Unser Angebot: Für eine oder einen von diesen Unbekannten würden wir eine Doppelgängerin oder einen Doppelgänger kreieren, und er oder sie sollte Gelegenheit erhalten, dieses Double zu treffen. Zu unserer Freude meldeten sich etwa 100 Personen aus verschiedenen europäischen Ländern. Datensatz 25, jener Datensatz, für den wir uns entschieden, weil hier besonders deutlich wurde, wie sich der Alltag einer Person über fünf Jahre teils minutengenau anhand der Daten rekonstruieren ließ, enthielt allein rund 100.000 Datenpunkte. Unser Ziel war es, daraus ein Profil zu erstellen, das so breit sein sollte, dass es in eine Rolle oder Figur verwandelt werden und von einer Schauspieler*in interpretiert werden könnte. Aber konnte eine Liste von Daten, die ja erstmal ausschließlich digitale Vorgänge zu erfassen schienen, tatsächlich ausreichen, um die Persönlichkeit eines Menschen zu ermitteln?
2015, als Instagram und TikTok noch gar keine Rolle spielten, hatten Forscher*innen der University of Cambridge und der Stanford University für Aufsehen gesorgt, als sie behaupteten: »Facebook kennt Dich besser als Freunde oder Familie«. Dieser griffigen These lag eine Studie zugrunde, die ermittelt hatte, dass zehn Facebook-»Likes« einer Person ausreichten, damit Facebook mehr über die Persönlichkeit dieser Person wisse als ein durchschnittlicher Arbeitskollege dieser Person. Dafür hatten die Forscher*innen untersucht, wie sehr das aus Facebook-Likes entstandene Bild der Persönlichkeit von 70.520 Teilnehmenden den Ergebnissen herkömmlicher Persönlichkeitstests entsprach. Mit 150 Likes sollte Facebook die Persönlichkeit besser einschätzen können als die Familie der betreffenden Person, und mit 300 Likes schließlich sollte der Facebook-Algorithmus den Ehepartner oder die -partnerin dieser Person übertreffen.14 Die von den Forscher*innen entwickelte Methode wurde durch den Psychometrie-Forscher Aleksandr Kogan, die Firma Cambridge Analytica und weitere Firmen missbraucht, um psychographische Profile von Millionen Facebook-Nutzer*innen zu erstellen und diese 2016 im US-Wahlkampf sowie beim Brexit-Referendum für maßgeschneiderte politische Werbung zu verwenden.15 Was im politischen Kontext als Skandal gehandelt wurde und für Facebook (Meta) Rekordstrafen in Milliardenhöhe zur Folge hatte, bildet jedoch auch weiterhin die Grundlage für das Micro-Targeting, mit dem Werbekunden von Meta (Facebook, Instagram), Alphabet (Google, YouTube), ByteDance (TikTok) und anderen Plattformen ihre Zielgruppen sehr präzise nach Alter, Geschlecht, Interessen, Verhalten und vielen weiteren Kriterien segmentieren können.16
Wenn unsere eigene Annahme und die Einschätzung vieler Datenwissenschaftler*innen stimmte, dann mussten jene Daten, die für unser künstlerisches Datenexperiment zur Verfügung standen – die bei der fünfjährigen Nutzung von Google und YouTube entstandenen Verhaltensspuren einer Person –, noch intimere Einblicke in die Persönlichkeit des unbekannten Menschen hinter den Daten gestatten. Während die Social-Media-Daten Rückschlüsse auf die Persönlichkeit des Menschen erlaubten, wie sie sich Arbeitskolleg*innen beziehungsweise Familienmitgliedern, Freund*innen oder vielleicht noch dem Partner oder der Partnerin gegenüber zeigte, müssten die Google-Daten uns auch offenbaren, wer jemand ist, wenn er/sie/they sich unbeobachtet wähnt – die wahre Persönlichkeit also?
Jede Suche, die ein Mensch bei Google tätigt, enthält neben den verwendeten Wörtern auch Metadaten, etwa die Zeit und den Ort der durchgeführten Suche. Diese Metadaten flossen in unsere Analyse ebenso ein wie die Suchbegriffe selbst. Die Datenspende bestand jedoch nicht nur aus Google-Suchen, die die unbekannte Person innerhalb von fünf Jahren getätigt hatte, sondern auch aus YouTube-Videos, die sie angesehen hatte, Spielen, die sie über den Playstore gekauft, und Wegen, die sie mit Google Maps zurückgelegt hatte. Zur Kategorisierung der einzelnen Daten orientierten wir uns an einem Dokument, das die Nichtregierungsorganisation Brave im November 2018 bei der Irish Data Protection Commission und dem UK Information Commissioner’s Office als Teil einer Beschwerde gegen Googles RTB-System einreichte. RTB steht dabei für »Real Time Bidding« – eine automatisierte Echtzeit-Versteigerung von Online-Werbeplätzen, für die unter anderem Google den Werbetreibenden das individuelle Nutzer*innen-Profil der Website-Besucher*innen zur Verfügung stellt. Welche Werbeanzeige jemand beim Besuch einer Website zu sehen bekommt, hängt davon ab, welcher Werbekunde von Google bereit war, für genau diesen Website-Besucher oder diese Besucherin mehr Geld zu bieten als alle anderen Mitbietenden.
Zwecks automatisierter Anzeige des User*innen-Profils werden die von Google ermittelten Eigenschaften, Interessen und Verhaltensweisen der Person in rund 6.000 Einzelkategorien zerlegt und entsprechend beziffert. Mithilfe dieser »publisher verticals« werden von Google etwa »Interessen« klassifiziert, zu denen solche eher banalen gehören wie »Autos« oder »Kosmetika«, aber auch solche hochsensiblen wie »Erziehung/Schwangerschaft« oder »Psychologie/Depression«.17 Sensible persönliche Daten, zu denen neben Gesundheitsdaten auch Daten zum Sexualleben, zur sexuellen Orientierung, zu politischen Überzeugungen oder zur ethnischen Zugehörigkeit zählen, dürfen für die gezielte Ansprache mit Werbung in der EU offiziell nicht genutzt werden.18 Die Bezeichnung »Interesse« soll deshalb offenbar verschleiern, dass die Person vielleicht nicht nur an einem Thema »interessiert« ist, sondern tatsächlich versucht, schwanger zu werden, oder eine Depression durchlebt – dass diese »Interessen« also in vielen Fällen auch hochsensible Informationen über privateste Angelegenheiten der Person liefern können. Alphabet (Google) und Meta (Facebook) sind nicht die einzigen Akteure im Online-Werbehandel, die sich solcher Methoden bedienen, selbst wenn sie weite Teile des Marktes beherrschen.19 Zu den Audience Segments, in die Microsofts Datenmarktplatz Xandr Menschen einzuordnen versucht, gehören Kategorien wie »Fragile Seniors«, »Moms Who Shop Like Crazy«, »Opiate Addiction«, »Eating Disorder«, »Passionate Lovers«, »Heavy Purchaser > Pregnancy Test Kits« oder Menschen mit der »General Attitude: I generally get a raw deal out of life«.20
Mittels algorithmischer, semantischer Analyse klassifizierten wir die Suchanfragen in den verschiedenen Kategorien und ordneten anschließend die Kategorien auf einer Zeitachse. Dies ermöglichte es uns, erste Muster zu erkennen. Die Korrelationen zwischen Kategorien schufen biographische Anhaltspunkte: Wir konnten zum Beispiel problemlos schlussfolgern, dass ein Umzug in eine andere Stadt mit der Entscheidung für einen neuen Job bzw. mit dem Beginn einer neuen Ausbildung in Verbindung stand. Um ihren Bodymass-Index ermitteln zu lassen, hatte unsere Datenspenderin ihre Größe und ihr Gewicht im Netz kundgetan. Wiederkehrende Suchen nach dem passenden Shampoo deuteten auf eine blonde Haarfarbe hin. Und obwohl wir uns vorgenommen hatten, nicht vorschnell stereotyp auf Gender und Geschlecht schließen zu wollen, überzeugten uns die häufigen Wortassoziationen zwischen »Frau« und diversen Mode-Artikeln, das fast vollständige Fehlen von queeren Themen und das Vorherrschen von Fragen, die sich ausschließlich auf die physische Gesundheit von Frauen bezogen, die Person hinter den Daten als eine wahrscheinlich cisgender-heterosexuelle Frau zu definieren.
Als Berater für unser Experiment konnten wir den Verhaltenswissenschaftler Clemens Stachl gewinnen. Er forschte zu dem Zeitpunkt im Media and Personality Lab am Department of Communication der Stanford University, das schon wegen seiner geographischen Nähe beste Einblicke in die Praxen der Tech-Unternehmen des Silicon Valley hat. Von Stachl lernten wir, wie verschiedene Datentypen mithilfe komplexer Verfahren aufbereitet und dann unter bestimmten Bedingungen mit Studienergebnissen aus den Verhaltenswissenschaften verknüpft werden können.21
3. Linksliberale Katzenliebhaber*innen vs.
rechtskonservative Hundehalter*innen
Für unser Experiment extrahierten wir Marken, Filme und Songs, die in den Google-Daten unserer Teilnehmerin wiederholt auftauchten, und brachten diese mit Persönlichkeitsdispositionen in Verbindung, die repräsentative psychologische Studien als statistisch häufige Korrelate solcher Vorlieben und Interessen ermittelt hatten.22 Zu den kuriosesten von ihnen gehört vielleicht die Erkenntnis, dass Menschen, die lieber Katzen als Hunde mögen, statistisch meist politisch weiter links stehen und liberal-progressiver wählen als Menschen, die Hunde bevorzugen.23 Ein anderes Beispiel: Menschen, die sich besonders stark vor Verletzungen und/oder Körperflüssigkeiten anderer Menschen ekeln, wählen auffällig oft rechte oder rechtsextreme Parteien.24 Mit einer Vielzahl solcher Korrelate lassen sich Prognosen über Interessen und Verhalten erstellen, ohne dass die Person selbst irgendeinen Hinweis auf ein entsprechendes Interesse oder Verhaltenspotential gezeigt haben muss. Der Zugriff auf die individuellen Verhaltens- und Kommunikationsdaten von Milliarden Menschen ermöglicht es den marktbeherrschenden Plattformen von Meta, Alphabet, Amazon und ByteDance (TikTok), immer detailliertere Verknüpfungen zwischen eigentlich unabhängigen Verhaltensweisen und Anzeichen von Interessen zu bilden.
Zwar gibt es keinen offensichtlichen Zusammenhang zwischen dem Ekel vor offenen Wunden und Körperflüssigkeiten einerseits und einem konservativen bis reaktionären politischen Wahlverhalten andererseits. Aber die ausreichend große Zahl an Daten, die die Tech-Giganten auswerten können, plus die Leistungsfähigkeit von Computern und Anwendungen maschinellen Lernens ermöglichen es den Unternehmen, auch solche Korrelationen zu eruieren, die Statistiker*innen bislang gar nicht erfassen konnten (und in einigen Fällen wohl nicht mal in Betracht gezogen hätten). Je mehr Interessen und Verhaltensweisen einer Person eruiert worden sind, desto leichter lassen sich algorithmisch weitere wahrscheinliche Interessen und Verhaltensmuster ausmachen. Den User*innen können schließlich Daten-Doppelgänger*innen zugeordnet werden, deren Verhaltensmuster und Interessen größtmögliche Übereinstimmung mit den Einzelpersonen aufweisen.25 Dieses Verfahren kommt im Grunde ohne jede Psychologie oder Politologie aus. Warum jemand, der oder die Katzen sehr viel lieber mag als Hunde, in Deutschland wahrscheinlich auch die Grünen der AfD vorzieht, ist für die Algorithmen der großen Datenunternehmen völlig unerheblich. Was zählt: Statistisch ist es derart häufig der Fall, dass sich diese Wette für die werbefinanzierten Tech-Konzerne und ihre Kund*innen lohnt.
Zusätzlich zu solchen direkten »Wenn, dann«-Ableitungen zwischen bestimmten Verhaltensweisen oder Interessen arbeiten manche Tech-Unternehmen mit Persönlichkeitsprofilen, die sie auf Basis des »OCEAN-Modells« erstellen,26 das im Rahmen des bereits erwähnten Cambridge-Analytica-Skandals erstmalig breitere Aufmerksamkeit erfahren hat. Dieses Modell ist in den Verhaltenswissenschaften allgemein anerkannt.27 Es unterscheidet die grundlegenden Persönlichkeitseigenschaften Openness, Conscientiousness, Extraversion, Agreeableness und Neuroticism. Die Persönlichkeitsstruktur eines Menschen wird anhand der Ausprägungen in diesen fünf großen Personality Traits ermittelt. Den verschiedenen Persönlichkeitsausprägungen sind wiederum bestimmte, statistisch häufige Verhaltensweisen zugeordnet. Besonders bemerkenswert für unser Experiment war etwa, dass Studien zufolge musikalische Vorlieben Aufschlüsse auf Persönlichkeitsausprägungen wie Conscientiousness oder Agreeableness erlauben sollen.28 Das half uns, aus den bei YouTube angesehenen Musikvideos auf Persönlichkeitsdispositionen unserer Experimentteilnehmerin zu schließen – unser Berater Clemens Stachl wurde nicht müde zu betonen, dass derlei Korrelationen nur in der statistischen Masse zuverlässig sind, nicht aber zwingend richtig sein müssen in Bezug auf jede einzelne Person. In Kombination mit verschiedenen anderen Korrelationen halfen uns solche wissenschaftlich nicht ganz sauberen Ableitungen aber, für unser künstlerisches Experiment iterativ die Persönlichkeit unserer ausgewählten Teilnehmerin immer mehr zu enthüllen. Oder kam uns das nur so vor? Aus den Daten war jedenfalls eine Erzählung geworden. Und diese Erzählung schien überzeugend. Aber stimmte sie auch?29
4. Krankheit als Chance (für Werbetreibende)
Indem wir die Analyse-Ergebnisse über die YouTube-Nutzung unserer Experimentteilnehmerin mit den Ergebnissen der semantischen Analyse der Google-Suchen verglichen und beides über die Metadaten wie Datum und Ort der Suchen miteinander verknüpften, konnten wir erkennen, dass Momente der Krankheit und des Unwohlseins positiv korrelierten mit Suchen nach esoterischen Angeboten, nicht zuletzt solchen auf YouTube. Hier tummelten (und tummeln sich noch immer) Gurus aller Couleur, Wunderheiler*innen, Tarot-Kartenleger*innen – Angebote, die für Menschen in einer stabilen mentalen Verfassung möglicherweise harmlos oder ganz uninteressant sind, die Menschen in emotionalen Ausnahmezuständen aber noch weiter destabilisieren können. Und in solchen Zuständen befand sich unsere Experimentteilnehmerin den Google- und YouTube-Daten zufolge in den fünf Jahren, auf die sich der Datensatz bezog, immer wieder: Eine Essstörung ließ sie nach gefährlichen Null-Diäten suchen; ein ungewollter Schwangerschaftsabbruch löste offenbar eine Depression aus. Eine längere Erkrankung, eine Kündigung und eine Trennung waren weitere einschneidende Ereignisse, die bewirkten, dass die Person nach Halt und Sinn im Leben suchte. Gab sie die entsprechenden esoterischen und spirituellen Suchbegriffe zunächst noch selbst in die Maske von Google und YouTube ein, wurden ihr vom Empfehlungsalgorithmus bald schon stundenlange, ununterbrochene Videokaskaden vorgeschlagen, ohne dass sie aktiv danach gesucht hätte.
Dass der Mutterkonzern von Google und YouTube – Alphabet – dabei ähnlich perfide agierte, wie es Facebook getan hatte, als das Unternehmen laut 2017 in Australien geleakten internen Dokumenten Werbekund*innen anbot, Teenager*innen gezielt in Schwächemomenten zu adressieren,30 also genau dann, wenn sie sich laut Facebooks Datenanalyse »stressed«, »defeated«, »overwhelmed«, »anxious«, »nervous«, »stupid«, »silly« oder »useless« fühlten, lässt sich nicht ausreichend belegen. Offensichtlich war für uns jedoch, wie stark der Einfluss der personalisierten Inhalte von YouTube & Co. auf die Gesundheit der jungen Frau hinter den Daten gewesen sein musste: Begann sie an der Wirkung der Schulmedizin zu zweifeln, weil die Medikamente gegen eine sich hinziehende Krankheit scheinbar keine Besserung brachten, wandte sie sich Alternativmediziner*innen auf YouTube zu und geriet dort in eine algorithmische Empfehlungsspirale, die sie zu kruden esoterischen Wunderheiler*innen führte. Besonders bestürzte uns, dass YouTubes Algorithmus sie zu solchen destruktiven Sehgewohnheiten offenbar immer wieder zurückbrachte, obwohl ihre eigenen aktiven Suchen verrieten, dass sie sich anderen Themen und Inhalten (berufliche Weiterbildung, Geschichte, Politik) zuzuwenden versuchte. Die vermeintlich für sie maßgeschneiderten Inhalte sprachen sie tatsächlich an, ent-sprachen ihr, aber nur genau jenem Teil ihrer Persönlichkeit, der den Algorithmen zufolge am meisten Screentime verhieß: der unbewusste, triebhafte, am schlechtesten zu kontrollierende Teil der menschlichen Persönlichkeit, der vor allem vom limbischen System im Gehirn gesteuert wird.31
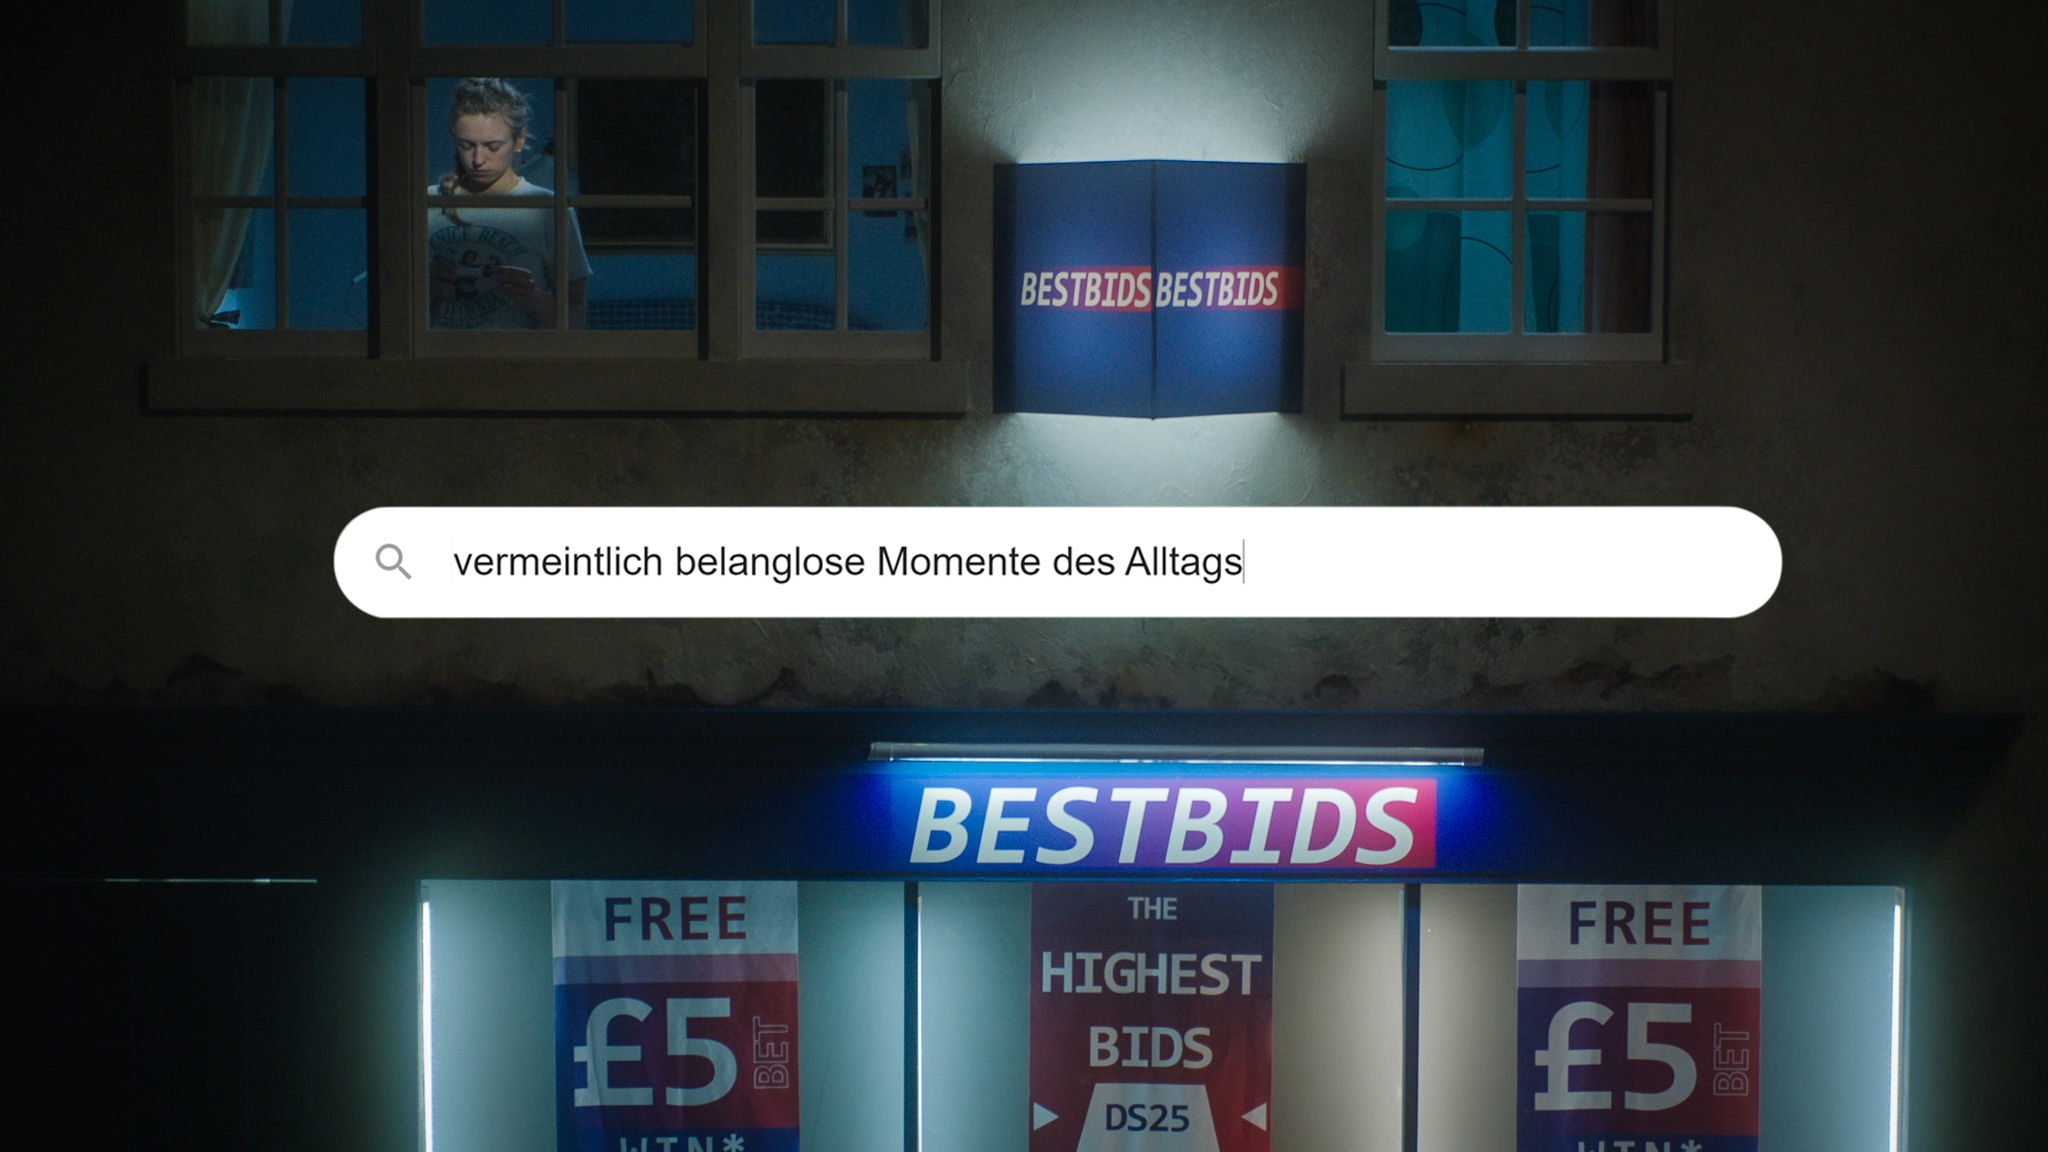
(© Laokoon/Konrad Waldmann)
Für die Rolle der Daten-Doppelgängerin engagierten wir die in Österreich lebende Schauspielerin Nathalie Ann Köbli. Anhand der Ergebnisse der algorithmischen Datenanalyse nahmen wir an, dass Köbli der Experimentteilnehmerin hinter Datensatz 25 optisch ähnelte und mutmaßlich auch einige biographische Parallelen bestanden, die im Casting zur Sprache gekommen waren. Das, so hofften wir, sollte es ihr erleichtern, neuralgische Momente aus dem Leben der Datenspenderin nachvollziehen und – im Rahmen eines Filmdrehs – »re-enacten« zu können. Von Momenten des Stresses bei der Arbeit über Momente der Entspannung, der sportlichen Verausgabung bis zu Momenten der Krankheit und der Krisen wählten wir Szenen aus, die gemäß der algorithmischen Analyse gehäuft aufgetreten waren, uns für das Leben unserer Teilnehmerin also typisch erschienen oder aber »Ausreißer« darstellten und insofern Wendepunkte markierten. Hieraus entstand das Drehbuch für einen Film, dessen Hauptfigur wir uns Stück für Stück, aus der Summe unzähliger Datenspuren und unserer Interpretationen zusammensetzten, ohne zu wissen, wie sehr sie am Ende der Person gleichen würde, die all diese Daten einmal produziert bzw. hinterlassen hatte. Auf einer großen Theaterbühne bauten wir die Kulissen ihres Lebens – etwa das mutmaßliche Schlafzimmer und Bad der Wohnung unserer unbekannten Datenspenderin, ihre Arbeitsstätte und ihre Stammkneipe – basierend auf unseren datenbasierten Hypothesen nach und statteten sie mit den in den Google-Daten identifizierten Einrichtungsgegenständen aus. Bei den wenigen Bereichen, für die im Google-Datensatz keine direkten Hinweise auf Einrichtungsvorlieben zu finden waren, machten wir uns die bereits erwähnten Studien des US-amerikanischen Psychologen Samuel Gosling zunutze, der Schlafzimmer und Arbeitsplätze von Menschen auf »Identity Claims«, »Behavioral Residues« und »Emotional Regulators« durchsuchen ließ und so Korrelationen ermitteln konnte zwischen den Inneneinrichtungen und den Persönlichkeitsdispositionen der Bewohner*innen.32
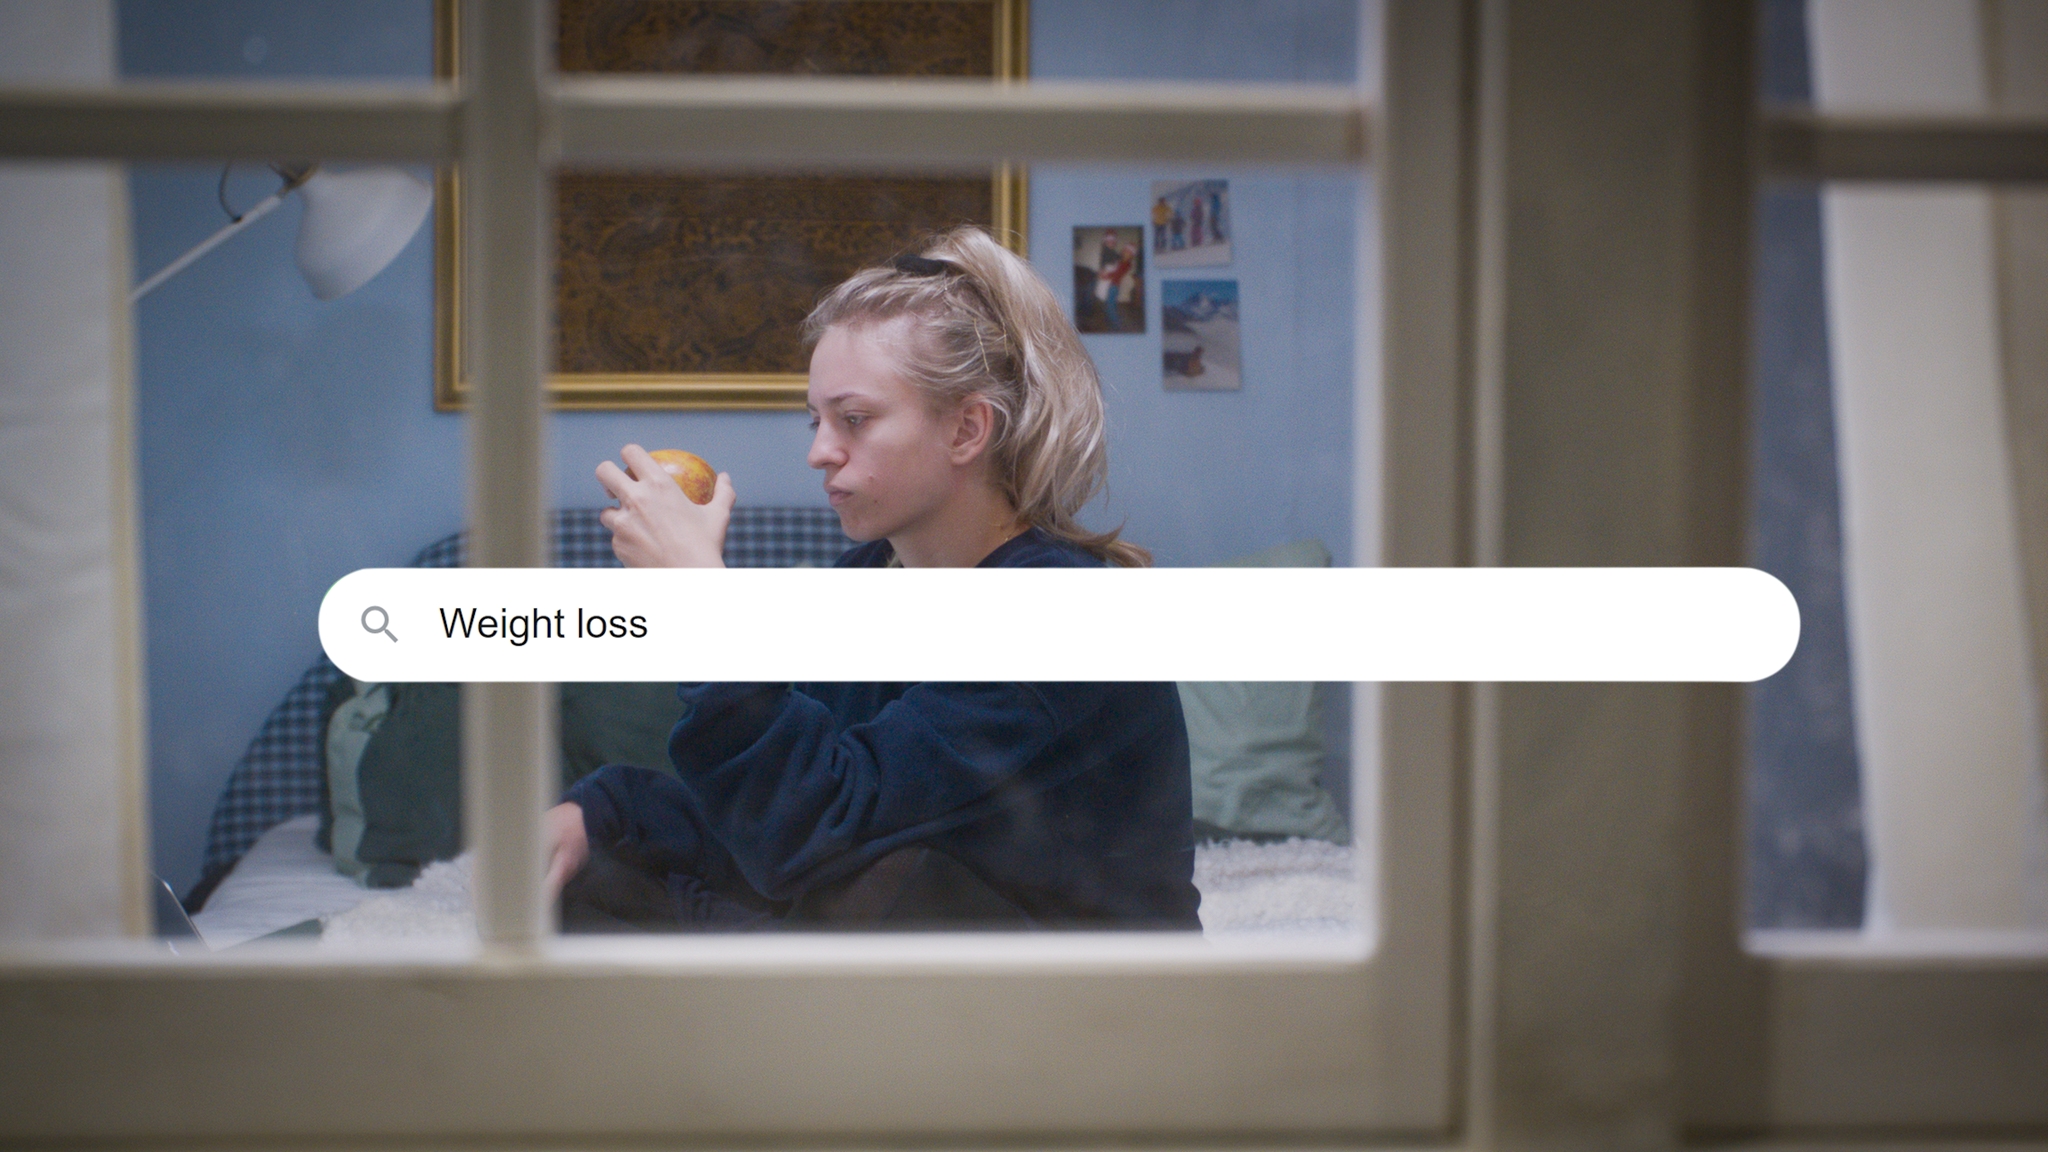
(© Laokoon/Konrad Waldmann)
Daten-Doppelgänger*innen machen es möglich, dass die Tech-Unternehmen solche informierten Wetten anstellen können darüber, was uns – nein, nicht uns, nur mir, mir ganz persönlich – gefallen könnte. »Nehmen wir an, ich suchte nach meinem Doppelgänger in einem Datensatz von zehn Leuten«, schreibt der Ex-Google-Datenwissenschaftler Seth Stephens-Davidowitz dazu. »Ich könnte jemanden finden, der oder die mein Interesse für Bücher teilt. Nehmen wir an, ich suchte nach meinem Doppelgänger in einem Datensatz von tausend Leuten. Ich könnte jemanden finden, der oder die einen Sinn für populärwissenschaftliche Physik-Bücher hat. Aber nehmen wir mal an, ich suchte nach meinem Doppelgänger in einem Datensatz von Hunderten Millionen von Menschen. Dann könnte ich jemanden finden, der oder die mir wirklich, wirklich ähnlich ist.«33
Nach Abschluss der Dreharbeiten mit der Doppelgängerin versuchten wir, die Person hinter den Daten über eine Instagram-Anzeige gezielt zu adressieren (Micro-Targeting), indem wir Angaben über ihren Wohnort mit demographischen Daten, Daten über ihren Familienstand, Interessen, Berufliches und vieles mehr kombinierten. Der kurze Videoclip rief die Datenspenderin dazu auf, eine eingeblendete Nummer zu wählen, falls sie sich wiedererkenne. Beim Schalten der personalisierten Werbung wurde von Instagram eine Warnung eingeblendet, die uns darüber informierte, dass nur eine Handvoll Personen, die unseren Kriterien entsprachen, die Anzeige sehen würden. Aber genau das wollten wir, die Anzeige war maßgeschneidert für unsere Experimentteilnehmerin. Tatsächlich meldete sich eine junge Frau bei unserem Produktionsteam, per Sprachnachricht. Aus dem Datenmenschen wurde ein Mensch mit Stimme, der deutlich anzuhören war, wie irritierend die Erfahrung gewesen sein musste, von einer zufällig gefundenen Werbeanzeige im Instagram-Feed persönlich angesprochen zu werden. Selbstverständlich hatte unser Team sie vorab über die Dimension und Tragweite unseres Experiments aufgeklärt und ihr jederzeit die Möglichkeit eingeräumt, Teile ihrer Daten beziehungsweise ganze Bereiche und Aspekte ihrer Biographie und ihres Alltags von der Thematisierung im Rahmen unseres Experiments auszunehmen. Diese Option hatte sie aber nicht genutzt. Und so enthielt schon der kurze Teaser, den wir für die persönliche Ansprache gestaltet hatten, Anspielungen auf private Bereiche ihres Lebens, die ihr eine vage Ahnung davon verschafften, was sie bei der Begegnung mit ihrer Daten-Doppelgängerin und im Film ihres Lebens erwartete.
(© Laokoon/Konrad Waldmann)
Als sich Original und Daten-Double schließlich in Wien begegneten und in einem Filmset gegenübersaßen, erzählte die Doppelgängerin von »ihrer« Schulzeit, »ihren« ersten Jobs, »ihren« Essstörungen und einer vorzeitig endenden Schwangerschaft – ganz so, als hätte sie, die Doppelgängerin, das alles selbst erlebt. Ein Kuscheltier, von dem sie erzählte, sie habe es selbst als Kind sehr geliebt und habe es deshalb ihrem Neugeborenen kaufen wollen, brachte die Experimentteilnehmerin aus der Fassung. Sie bat um eine Pause. Offenbar war es das eine stimmige Detail zu viel gewesen, das jetzt das Fass an Intimität zum Überlaufen brachte. Die Teilnehmerin zweifelte, dass tatsächlich nur die vereinbarten Google-Daten herangezogen worden waren, um der Doppelgängerin all diese Erzählungen aus der Ich-Perspektive zu erlauben. Doch so war es. Während die Begegnung zwischen Original und Daten-Double andauerte, schien sich die innere Haltung der Experimentteilnehmerin zu verändern: Aus der Hoffnung auf Selbsterkenntnis im Spiegel der Anderen und dem anfänglichen Eindruck der Komplizinnenschaft schien ein Gefühl der Konkurrenz und Entfremdung entstanden zu sein.
Was war geschehen? Um es gleich vorwegzunehmen: Unsere Trefferquote war alles andere als perfekt. Immer wieder hatten wir Suchen missgedeutet, sicher geglaubte kausale Zusammenhänge entpuppten sich zum Teil als völlig zusammenhangslos. Bewies unser Experiment also letztlich, was der ehemalige Google-Mitarbeiter, Programmierer und Jurist Tim Hwang in seinem Buch »Subprime Attention Crisis« als großangelegte Betrugsmasche der Online-Werbeindustrie darstellt?34 Hwang hegt zumindest erheblichen Zweifel daran, wie akkurat die Persönlichkeitsprofile, die Meta, Alphabet & Co. aus den persönlichen Daten ihrer Nutzer*innen entwickelt haben wollen, tatsächlich sind und wie passgenau und erfolgreich entsprechend das Micro-Targeting.
Bei der Konfrontation der Erzählungen unseres Daten-Doubles mit den Erinnerungen der realen Person stimmten diverse Einzelheiten nicht überein. Ein zunächst banaler Streitpunkt zwischen Original und Double war ein Urlaub in Barcelona. Dass die Doppelgängerin (basierend auf Metadaten und einfachen Rückschlüssen aus Google Maps & Co.) von dem Urlaub besser (das heißt akkurater, präziser) berichten konnte als sie selbst, diesen Gedanken wollte die Experimentteilnehmerin anfangs nicht zulassen. Je mehr solcher Momente zustande kamen, desto mehr schwankte sie jedoch zwischen vehementem Widerspruch und sichtbarer Verunsicherung. Dies gipfelte in einem Moment, in dem wir die Teilnehmerin fragten, ob sie tatsächlich an jener Adresse in London gewohnt habe, die wiederholt in den Daten aufgetaucht war und die uns zum detailgetreuen Nachbau jenes Hauses animiert hatte, das wir unter dieser Adresse auf Google Street View gefunden hatten: ein markantes blaues Gebäude mit Wettbüro in der unteren Etage, direkt unter ihrer (vermeintlichen) Wohnung. Erst widersprach die Experimentteilnehmerin, dann zögerte sie, dann redete sie sich ein, sie sei vermutlich nur immer über einen anderen Eingang aus dem Haus gegangen, aber konnte das sein? Es war nur einer von mehreren Momenten, in denen die aus den Daten abgeleiteten »Erinnerungen« ihrer Doppelgängerin die eigenen Erinnerungen derart zu korrumpieren schienen, dass sie ins Straucheln geriet, wenn sie versuchte, sich auf ihr Gedächtnis zu stützen. Offenbar hatten drei aufeinander folgende Tage, an denen die Doppelgängerin ihre Rolle als datenbasierte »Besserwisserin« hervorragend gespielt hatte, dafür gesorgt, dass das Vertrauen in die Zuverlässigkeit der eigenen Erinnerungen zumindest angekratzt war. Die Teilnehmerin erschrak und brach das Experiment an diesem Punkt ab.
Ob der Versuch, eine wahrhaftige Doppelgängerin zu »erschaffen«, geglückt war, schien inzwischen nebensächlich. Obwohl wir Vorkehrungen getroffen, also etwa mehrere Psychologinnen zu Rate gezogen und eine Psychotherapeutin engagiert hatten, die die Teilnehmerin auf Wunsch jederzeit hätte konsultieren können, hatten wir unsere Verantwortung als Initiator*innen des Experiments deutlich unterschätzt. Immerhin hatten wir einen Menschen einer offenbar ziemlich erschütternden Erfahrung ausgesetzt. Zwar wussten wir vorher von psychologischen Experimenten, in denen Menschen False Memories beigebracht worden sein sollen. Die US-amerikanische Psychologin Elizabeth Loftus hat seit den 1970er-Jahren mit beeindruckenden Studien klargemacht, wie anfällig die Erinnerungen von Augenzeug*innen für nachträgliche Manipulationen sind, die etwa durch Suggestivfragen herbeigeführt werden können.35 Die Psychologin Julia Shaw ging 2015 sogar so weit zu behaupten, sie habe 70 Prozent der unschuldigen Proband*innen davon überzeugt, ein Verbrechen begangen zu haben und sich nun an dieses zu erinnern.36 Die Bedingungen solcher Studien unterschieden sich jedoch stark von denen unseres Experiments – schon durch die Tatsache, dass es bei uns nicht um ein vermeintliches Delikt und die daraus entstandene Schuld ging, aber auch durch die Rahmung als Kunstprojekt und den Umstand, dass die Experimentteilnehmerin (anders als etwa im Reality-TV üblich) erst nach Abschluss des Experiments und aller Filmaufnahmen entscheiden sollte, ob sie mit der Veröffentlichung einverstanden war oder nicht, und wir uns bemühten, keinerlei Druck auszuüben. Entsprechend hielten wir selbst und die uns beratenden Psychologinnen es nicht für wahrscheinlich, dass wir die Erinnerungen unserer Teilnehmerin ähnlich stark irritieren würden, wie es in den forensischen Experimenten geschehen war. Warum aber war unser Experiment dann trotzdem so entgleist?
Die direkte Konfrontation mit den (vermeintlichen) »Reenactments« im Film und der (vermeintlichen) Doppelgängerin innerhalb eines Wochenendes war belastender gewesen als von uns vermutet. Während wissenschaftliche Forschungsvorhaben am Menschen die vorherige Freigabe durch eine Ethikkommission voraussetzen, gibt es im Kunst- und Medienbetrieb kein vergleichbar strenges Prozedere. Auch wenn die Freiheit der Kunst ein hohes Gut ist und bei entsprechender Aufklärung Teilnehmer*innen durchaus mündig und selbstbestimmt entscheiden können sollten, ob sie an einem derartigen Projekt teilnehmen oder nicht, stellt sich die Frage, ob solche psychologisch heiklen Experimente – ganz gleich, wie reizvoll sie in künstlerischer Hinsicht sein mögen – überhaupt stattfinden sollten. Wir gaben unserer Teilnehmerin nach Abbruch des Experiments Bedenkzeit, ob sie die bis dahin gefilmte Dokumentation zur Veröffentlichung freigeben wolle oder nicht, und boten ihr an, das Experiment in der Doku kritisch zu kommentieren. Sie stimmte der Publikation, wie sie sagte, schließlich auch deshalb uneingeschränkt zu, weil sie andere junge Menschen für die Beeinflussung durch die großen Datenunternehmen sensibilisieren wollte. Wir sind weiter im Kontakt mit ihr. Nach allem, was wir wissen, hat das Experiment bei ihr zum Glück keine psychischen Schäden hinterlassen. Trotzdem bereuen wir es, die Teilnehmerin solch einer Belastung ausgesetzt zu haben.
Medial wurde unser Experiment dagegen überaus positiv besprochen.37 Denn es zeigte auf bisher beispiellose Weise, welche ungeheure und weithin unterschätzte Macht digitale Daten bzw. diejenigen, die über sie verfügen, besitzen. Die Intransparenz darüber, wann, wie, wo und wozu die marktbeherrschenden Tech-Konzerne Daten erlangen und wie mithilfe von maschinellem Lernen daraus Erkenntnisse über uns gewonnen werden können, schürt eine Unsicherheit, die uns Menschen empfänglich macht für vermeintlich objektive (weil datengestützte) Fremdbeschreibungen und Angebote, die sich als »maßgeschneidert« ausgeben. Entscheidend ist hierfür nicht, in welchem Umfang das aus den Daten abgeleitete Bild eines Menschen, seines Verhaltens und seiner Persönlichkeit zutrifft (denn das lässt sich ja ohnehin nicht abschließend klären). Entscheidend ist vielmehr, dass das Potential von Anwendungen maschinellen Lernens, aus persönlichen Daten eine vermeintlich objektive Gewissheit über den Menschen hinter den Daten auszulesen, derart überschätzt wird, dass hieraus eine Aura der Wahrheit entsteht, hinter der das Selbstbild verblasst.
Ich ist eine Suchmaschine – so lautete der Titel einer interaktiven Installation, die ich 2021 zusammen mit Cosima Terrasse und Hans Block für die Ars Electronica in Linz realisiert habe und die auf unserem beschriebenen künstlerischen Datenexperiment basierte.38 Frei nach Kleist könnte man auch von der allmählichen Verfertigung des Ichs beim Eingeben von Fragen in Suchmasken sprechen. Denn Google und nun auch immer häufiger ChatGPT, Gemini oder andere KI-Tools, die von vielen Menschen laufend konsultiert werden, kuratieren mit jedem Rat- und Vorschlag, was wir lesen, hören, sehen und letztlich mögen, wie wir uns verhalten, was wir lieber vermeiden – kurzum: Sie nehmen massiv Einfluss auf alles, was sich als Ausdruck unserer Persönlichkeit beschreiben ließe. Anders als bei der Idee einer Seele als fixer Essenz unserer Persönlichkeit befindet sich die menschliche Seele im Digitalzeitalter in einem ständigen Feedback-Loop: Mit jedem Post, den wir absetzen, erwarten wir die Rückmeldungen der Anderen, die unseren nächsten Post beeinflussen werden. Und mit jeder Eingabe bei Google, ChatGPT & Co. rufen wir hinein in die Black Boxes: Wer bin ich? Wer könnte ich sein? Wer sollte ich sein? Laut »Postbank Digitalstudie« waren 18- bis 39-Jährige im Jahr 2025 in Deutschland durchschnittlich fast 86 Stunden pro Woche online.39 Inzwischen bewegen sich die meisten Menschen im Netz vorwiegend in algorithmisch kuratierten Umgebungen: Suchergebnisse, Videos auf Streamingplattformen, Nachrichtenartikel und Social-Media-Feeds – solange wir uns nicht aktiv gegen die Personalisierung von Inhalten zur Wehr setzen, sind wir überwiegend umgeben von Ansprachen an uns, die uns suggerieren, sie seien wie gemacht für uns, nein, nicht für uns – nur für mich – für mich persönlich. Fragt man Menschen, ob sie glauben, von diesen persönlichen Ansprachen und Angeboten in ihrem Denken und Handeln beeinflusst zu werden, leugnen die meisten, stark beeinflussbar zu sein.40 Nicht nur verletzt es unseren Stolz, es entspricht auch einfach nicht unserer Selbstwahrnehmung. Zwar ist spätestens seit Aufkommen der Psychoanalyse gemeinhin bekannt, dass wir Menschen in unserem Denken, Fühlen und Handeln oft beeinflusst werden, ohne es uns in dem Moment selbst bewusst zu machen. Trotzdem scheinen wir uns kontinuierlich weismachen zu wollen, Herr*in im eigenen Haus zu sein, also selbstbestimmt, bewusst und logisch zu handeln. Verschiedenste psychologische Experimente legen nahe, dass unser Gehirn in den Fällen, in denen wir uns unser eigenes Handeln nicht erklären können, Motivationen für unser Handeln erfindet, die wir uns dann selbst glauben.41
Der Kognitions- und Neurowissenschaftler Wolfgang Prinz kommt in seiner Theorie des Geistes unter dem Titel »Selbst im Spiegel« zu dem Schluss, dass das, was wir als »Ich« empfinden, im Grunde eine Art Geschichte sei, die wir uns von uns selbst erzählen, weil wir sie so durch andere erfahren haben.42 Diese Erfahrungen, wer ich für andere bin, mache ich aber in den seltensten Fällen in dem Bewusstsein, dass hier gerade mein Ich konstruiert wird. Das Ich konstituiert sich vielmehr kontinuierlich. Bis ins hohe Alter befindet sich unser Ich in einer allmählichen Verfertigung, in einem lebenslangen Versuchs- und Vorschlagsmodus.43 »Wir müssen uns selbst ständig unserer eigenen Identität versichern«, schreibt die Philosophin Isolde Charim. »Wir sind weniger selbstverständlich Ich. Wir leben im identitären Prekariat.«44 Das macht uns Menschen, ob wir wollen oder nicht, empfänglich für Fremdbeschreibungen, die wir (mal mehr, mal weniger explizit) durch unsere Umwelt empfangen – und heutzutage eben zunehmend durch unsere digitale Umwelt. Wie entscheidend ist es da noch, ob diese Suggestionen, die kontinuierlich in Form von vorgeschlagenen Inhalten in Social-Media-Feeds und personalisierten Werbebotschaften an uns herangetragen werden, tatsächlich uns, nein, nicht uns, nur mir, mir ganz persönlich entsprechen? Wie entscheidend ist es, ob Alphabet (Google), Meta (Facebook) oder ByteDance (TikTok) mich und meine Persönlichkeit wahrhaftig und gänzlich zu erfassen imstande sind, wenn sie beziehungsweise ihre Werbekund*innen diese Persönlichkeit ja ohnehin beständig mitformen und verformen können?45 Wie entscheidend ist es für ihren wirtschaftlichen Profit, ob sie meine Sehnsüchte, Ängste und Nöte durchleuchtet oder aber vielmehr erst geschaffen haben? Ob wir wollen oder nicht, richten wir uns nach den Identitätsangeboten, die uns online auf Schritt und Tritt verfolgen, bis wir durch unser Kauf- und Rezeptionsverhalten bestätigen, dass diese vorgeschlagenen Videos, Songs, Kleidungsstücke, Geräte, Urlaube etc. genau zu uns passen – eine Identität, die wir als Essenz unserer ureigenen Persönlichkeit verkennen, statt sie als Produkt einer Industrie von Identitätsangeboten zu erkennen. So sind die maßgeschneiderten Ansprachen an uns letztlich vor allem eines: selbsterfüllende Prophezeiungen.
Ein möglicher Ansatz zum Widerstand ist natürlich immer, etwas weniger Bequemlichkeit, etwas mehr Friktion zu riskieren und einige digitale Hilfsmittel schlichtweg ungenutzt zu lassen oder, wie es etwa aktuell in manchen jugendlichen Kreisen Mode wird, zu »Dumbphones« – Handys ohne Internetzugang – zurückzukehren. Ein anderer Ansatz stammt von der Informationswissenschaftlerin Helen Nissenbaum und dem Medienwissenschaftler Finn Brunton: Durch die gezielte Erzeugung mehrdeutiger, irreführender und verwirrender Informationen – kurz: Obfuscation (Vernebelung) – könne jede*r Einzelne dazu beitragen, die Zuverlässigkeit und den Wert von Datenansammlungen zu verringern.46 Auch wenn dadurch keine grundlegende Umkehr der Machtverhältnisse erreicht werde, könne Obfuscation dabei helfen, Profilbildung und die Berechenbarkeit unseres Verhaltens zu erschweren. Selbst wenn fraglich ist, wie viele Menschen die Ressourcen und das Privileg besitzen, sich auf diese Weise wehren zu können, treffen Nissenbaum und Brunton in meinen Augen einen Punkt: Erst wenn wir uns wieder als Homines ludentes begreifen,47 als zum Spiel begabte Wesen, statt wie die Kaninchen vorm Fuchsbau der Datenunternehmen zu erstarren, erst wenn wir unsere Wandelbarkeit und Vielgestaltigkeit als Ausdruck unseres Menschseins wiederentdecken, erst dann werden wir uns von dem Fluch des Narrativs unserer Berechenbarkeit befreien können. Ob es uns im Digitalzeitalter gelingt, unsere Autonomie zu verteidigen, könnte deshalb künftig weniger davon abhängen, ob wir digitale Doppelgänger*innen haben, ob es uns einmal, zweimal, dreimal oder tausendfach gibt – sondern ob wir es sind, nein, nicht wir, nur ich, ich höchstpersönlich, der me, myself and I immer wieder neu erfindet und mir und all meinen Doppelgänger*innen erzählt, wer sie sind. Nicht, wer sie »wirklich« sind – sondern wer sie sein könnten.
Anmerkungen:
1 Jule Specht (Hg.), Personality Development Across the Lifespan, London 2017.
2 Moritz Riesewieck/Hans Block, Die digitale Seele. Unsterblich werden im Zeitalter Künstlicher Intelligenz, München 2020.
3 Alex »Sandy« Pentland, Professor am MIT Media Lab, führte schon 2014 aus, wie durch die KI-Analyse von Kommunikationsmustern und sozialen Interaktionen Verhaltensweisen angeblich präzise vorhergesagt werden könnten: Alex Pentland, Social Physics. How Good Ideas Spread. The Lessons from a New Science, New York 2014.
4 Ray Kurzweil, The Singularity Is Near. When Humans Transcend Biology, New York 2005.
5 Hans Block/Moritz Riesewieck, Eternal You. Vom Ende der Endlichkeit, Dokumentarfilm, D/USA 2024.
6 Anm. der Red.: In der Geschichtswissenschaft und der Public History wird dies speziell für »Hologramme« von Holocaust-Überlebenden kritisch diskutiert; siehe etwa Axel Doßmann, Unsterbliche Zeugen. Holographische 3D-Projektionen als Symptom einer Krise, in: Einsicht 2019. Bulletin des Fritz Bauer Instituts, S. 68-77; ders., Holografische Zeitzeug:innen, in: Linde Apel/Stefan Müller (Hg.), Handbuch Oral History. Von A wie Aufnahmegerät bis Z wie Zuhören, Paderborn 2026, S. 172-174.
7 Cosima Terrasse/Moritz Riesewieck/Hans Block, Wo du mich findest, Theaterstück, Münchner Kammerspiele 2022.
8 Zur Geschichte der »Sortierung« der Gesellschaft und zur automatisierten Mustererkennung vgl. Armin Nassehi, Muster. Theorie der digitalen Gesellschaft, München 2019; Steffen Mau, Das metrische Wir. Über die Quantifizierung des Sozialen, Berlin 2017. Früher bereits Theodore M. Porter, Trust in Numbers. The Pursuit of Objectivity in Science and Public Life, Princeton 1995.
9 Samuel D. Gosling/Sam Gaddis/Simine Vazire, Personality Impressions Based on Facebook Profiles, International Conference on Weblogs and Social Media, Boulder, March 2007.
10 Samuel D. Gosling, Snoop. What Your Stuff Says About You, New York 2008.
11 Vgl. Sandra Matz, Mindmasters. The Data-Driven Science of Predicting and Changing Human Behavior, Boston 2025.
13 Das europäische Datenschutzgesetz verlangt zum Zeitpunkt der Veröffentlichung dieses Essays von Unternehmen nur, dass sie Zugang zu jenen Daten gewähren, die unter den Klarnamen der Nutzer*innen gespeichert sind bzw. eindeutig einer Person zugeordnet werden können. Was nicht in der Datenauskunft enthalten sein muss, sind Daten, die unter Pseudonymen gespeichert werden, sofern sie (vermeintlich) keine klare Zuordnung erlauben – ein Verfahren, von dem Google, Facebook, TikTok & Co. reichlich Gebrauch machen, weil sie so noch immer (höchst intransparent) Profile anlegen, User*innen verfolgen und targeten können, ohne dass die User*innen selbst oder gar die Öffentlichkeit erfahren, wie diese passgenauen Werbeansprachen zustande gekommen sind. Doch selbst die Anzahl der Datenpunkte, die Google/Alphabet unter den Klarnamen der Nutzer*innen speichert, ist in den meisten Fällen beeindruckend.
14 Wu Youyou/Michal Kosinski/David Stillwell, Computer-Based Personality Judgments Are More Accurate than those Made by Humans, in: Proceedings of the National Academy of Sciences of the United States of America 112 (2015), S. 1036-1040.
15 Carole Cadwalladr/Emma Graham-Harrison, Revealed: 50 Million Facebook Profiles Harvested for Cambridge Analytica in Major Data Breach, in: Guardian, 17.3.2018.
16 Zu den historischen Vorläufern von Cambridge Analytica vgl. Jill Lepore, If Then. How the Simulmatics Corporation Invented the Future, New York 2020.
17 Vgl. [Johnny Ryan, What Google Knows About You and Your Website. How Google Extracts Publisher Categories From Websites and Uses Them to Target Users, Brave Software 2020,] URL: <https://brave.com/static-assets/files/Google-publisher-verticals-marked-up.pdf>.
18 Vgl. Artikel 26 Absatz 3 Digital Services Act (DSA) der EU.
19 Peter Westberg, The Rise of Google, Meta, Amazon, and YouTube in Advertising, in: Quartr Insights/Company Research, 1.3.2024, Update 11.11.2025.
20 Ingo Dachwitz, Microsofts Datenmarktplatz Xandr. Das sind 650.000 Kategorien, in die uns die Online-Werbeindustrie einsortiert, in: netzpolitik.org, 8.6.2023. Konsument*innen-Typologien hat die Markt- und Konsumforschung auch in vordigitalen Zeiten schon erstellt – vgl. etwa Nepomuk Gasteiger, Der Konsument. Verbraucherbilder in Werbung, Konsumkritik und Verbraucherschutz 1945–1989, Frankfurt a.M. 2010. Im digitalen Zeitalter sind jedoch nicht nur die Kategorien erheblich granularer geworden, sondern auch das Tracken von tatsächlichen Verhaltensweisen in scheinbar unbeobachteten Momenten ist möglich geworden, was einen deutlichen Unterschied darstellt zur Beobachtung von Konsument*innen-Verhalten im öffentlichen und halb-öffentlichen Raum sowie entsprechenden telefonischen Befragungen.
21 Vgl. Clemens Stachl u.a., Personality Traits Predict Smartphone Usage, in: European Journal of Personality 31 (2017), S. 701-722.
22 Jennifer Golbeck/Eric Norris, Personality, Movie Preferences, and Recommendations, in: ASONAM ʼ13: Proceedings of the 2013 IEEE/ACM International Conference on Advances in Social Networks Analysis and Mining, Niagara Falls 2013, S. 1414-1415; Riza Casidy Mulyanegara/Yelena Tsarenko/Alastair Anderson, The Big Five and Brand Personality. Investigating the Impact of Consumer Personality on Preferences Towards Particular Brand Personality, in: Journal of Brand Management 16 (2009), S. 234-247; Ian Anderson u.a., »Just the Way You Are«. Linking Music Listening on Spotify and Personality, in: Social Psychological and Personality Science 12 (2021), S. 561-572.
23 Chantelle Ivanski/Ronda F. Lo/Raymond A. Mar, Pets and Politics. Do Liberals and Conservatives Differ in Their Preferences for Cats Versus Dogs?, in: Collabra: Psychology 7 (2021) H. 1, Art. 28391.
24 Patrick Fournier/Michael B. Petersen/Stuart Soroka, The Political Phenotype of the Disgust Sensitive. Correlates of a New Abbreviated Measure of Disgust Sensitivity, in: Electoral Studies 72 (2021), Art. 102347.
25 Vgl. Sara M. Watson, Data Doppelgängers and the Uncanny Valley of Personalization. Why customized ads are so creepy, even when they miss their target, in: Atlantic, 16.6.2014; Seth Stephens-Davidowitz, You Have Doppelgängers. They’re Quietly Influencing Your Life, 25.2.2019, URL: <https://www.youtube.com/watch?v=2raflHttBcg>; Melissa Henley, Digital Twins. Can They Transform Customer Experience?, in: CMSWire/Customer Experience, 19.1.2024.
26 Sandra Matz/Yin Wah Fiona Chan/Michal Kosinski, Models of Personality, in: Marko Tkalčič u.a. (Hg.), Emotions and Personality in Personalized Services. Models, Evaluation and Applications, Cham 2016, S. 35-54.
27 Michael S. Chmielewski/Theresa A. Morgan, Five-Factor Model of Personality, in: Marc D. Gellman/J. Rick Turner (Hg.), Encyclopedia of Behavioral Medicine, New York 2013, S. 803-804.
28 Anderson u.a., »Just the Way You Are« (Anm. 22).
29 Anm. der Red.: Hier ergeben sich Schnittmengen mit einer Geschichtswissenschaft, die an Lebensläufen und (auto-)biographischem Erzählen sowie am Verhältnis von Faktizität und Fiktionalität in der Historiographie interessiert ist. Siehe etwa Thomas Etzemüller, Henning von Rittersdorf: Das Deutsche Schicksal. Erinnerungen eines Rassenanthropologen. Eine Doku-Fiktion, Bielefeld 2021; ders., Was wahr sein könnte. Plädoyer für eine fiktionale Empirie, in: Merkur 72 (2018) H. 12, S. 17-28; ders., An der Grenze. Geschichtsschreibung zwischen Fakt und Fiktion, in: Merkur 80 (2026) H. 2, S. 5-17.
30 Sam Levin, Facebook Told Advertisers It Can Identify Teens Feeling ›Insecure‹ and ›Worthless‹, in: Guardian, 1.5.2017.
31 Einerseits ist es uns bei der Besprechung unseres Datenexperiments wichtig, darauf hinzuweisen, dass keineswegs »nur« psychisch labile, besonders »leichtgläubige« oder anderweitig anfällige Personengruppen von den algorithmisch maßgeschneiderten Empfehlungen etwa zu einem gesundheitsschädlichen Medienkonsum oder zu Kaufentscheidungen verleitet werden können. Je gefeiter wir uns wähnen, desto anfälliger werden wir für Manipulationen unseres Verhaltens. Andererseits beeinflussen Faktoren der sozialen Ungleichheit selbstverständlich auch im digitalen Raum die jeweilige Vulnerabilität der Menschen.
32 Samuel D. Gosling u.a., A Room with a Cue. Personality Judgments Based on Offices and Bedrooms, in: Journal of Personality and Social Psychology 82 (2002), S. 379-398.
33 Seth Stephens-Davidowitz, Everybody Lies. Big Data, New Data, and What the Internet Can Tell Us About Who We Really Are, New York 2017, S. 201 (meine Übersetzung).
34 Tim Hwang, Subprime Attention Crisis. Advertising and the Time Bomb at the Heart of the Internet, New York 2020.
35 Elizabeth F. Loftus/John C. Palmer, Reconstruction of Automobile Destruction. An Example of the Interaction Between Language and Memory, in: Journal of Verbal Learning and Verbal Behavior 13 (1974), S. 585-589; Elizabeth F. Loftus, Lost in the Mall. Misrepresentations and Misunderstandings, in: Ethics & Behavior 9 (1999), S. 51-60; dies., Leading Questions and the Eyewitness Report, in: Cognitive Psychology 7 (1975), S. 560-572.
36 Julia Shaw/Stephen Porter, Constructing Rich False Memories of Committing Crime, in: Psychological Science 26 (2015), S. 291-301.
37 Siehe u.a. Steffen Grimberg, Bis du dich wiedererkennst, in: taz, 30.8.2021, S. 13 (»Das ist große Datenkunst und unglaublich spannend.«); Andrea Gerk, Die Doppelgängerin, die zu viel weiß, in: Deutschlandfunk Kultur, 28.8.2021 (»Das Ergebnis ist verblüffend und gruselig zugleich.«); Carola Padtberg, Lisa, Datenspenderin Nummer 25, trifft ihre Doppelgängerin, in: Spiegel, 29.8.2021 (»Made to Measure macht eine Problematik auf der Gefühlsebene erlebbar, von der Internetnutzer zwar oft wissen, aus der sie aber selten Konsequenzen ziehen.«).
38 Made to Measure. Journey, in: Ars Electronica – A New Digital Deal, Linz (Festival und Online-Plattform), 2021. Zur Kulturgeschichte der Suchmaschine vgl. David Gugerli, Suchmaschinen. Die Welt als Datenbank, Frankfurt a.M. 2009.
39 <https://www.postbank.de/unternehmen/medien/meldungen/2025/september/rekord-deutsche-sind-ganze-drei-tage-pro-woche-online.html>.
40 Nora Moran, Illusion of Safety. How Consumers Underestimate Manipulation and Deception in Online (vs. Offline) Shopping Contexts, in: Journal of Consumer Affairs 54 (2020), S. 890-911; Richard M. Perloff, Third-Person Effect Research 1983–1992. A Review and Synthesis, in: International Journal of Public Opinion Research 5 (1993), S. 167-184.
41 Lars Hall/Petter Johansson/Thomas Strandberg, Lifting the Veil of Morality. Choice Blindness and Attitude Reversals on a Self-Transforming Survey, in: PLOS ONE 7 (2012) H. 9, e45457; Michael S. Gazzaniga, Rechtes und linkes Gehirn. Split Brain und Bewußtsein, in: Spektrum der Wissenschaft 12/1998, S. 84.
42 Wolfgang Prinz, Selbst im Spiegel. Die soziale Konstruktion von Subjektivität. Aus dem Englischen von Jürgen Schröder, Berlin 2013.
43 Jule Specht/Michaela Luhmann/Clemens Geiser, On the Consistency of Personality Types Across Adulthood. Latent Profile Analyses in Two Large-Scale Panel Studies, in: Journal of Personality and Social Psychology 107 (2014), S. 540-556.
44 Isolde Charim, Ich und die Anderen. Wie die neue Pluralisierung uns alle verändert, Wien 2018, 4. Aufl. 2019, S. 47f. Vgl. hierzu auch Andreas Reckwitzʼ Konzept der subjektiven Singularität, demzufolge jede*r von uns zur Selbstvermarktung angehalten wird: Andreas Reckwitz, Die Gesellschaft der Singularitäten. Zum Strukturwandel der Moderne, Berlin 2017.
45 Laura Vandenbosch/Steven Eggermont, The Interrelated Roles of Mass Media and Social Media in Adolescents’ Development of an Objectified Self-Concept. A Longitudinal Study, in: Communication Research 43 (2016), S. 1116-1140.
46 Finn Brunton/Helen Nissenbaum, Obfuscation. A User’s Guide for Privacy and Protest, Cambridge, Mass. 2015.
47 Frei nach Johan Huizinga, Homo ludens. Vom Ursprung der Kultur im Spiel, 21. Aufl. Hamburg 2009 (zuerst 1938).