
[Für kritische Anmerkungen danken wir Marcus Böick, Martin Schmitt, Niklas Weber und der Redaktion der Zeithistorischen Forschungen.]
Nach der kopernikanischen Wende, Darwins Evolutionstheorie und Freuds Theorie des Unbewussten ist die Durchsetzung neuer Formen generativer Künstlicher Intelligenz, allen voran die rasante Verbreitung großer Sprachmodelle (Large Language Models, LLMs), jüngst vielfach als »vierte Kränkung« des Menschen bezeichnet worden. Unsere Erde steht nicht im Zentrum des Universums, wir Menschen sind letztlich auch nur eine Tierart unter vielen, wir können unser Denken und Handeln nicht vollständig kontrollieren, und jetzt gibt es auch noch Maschinen, die immer erfolgreicher den Eindruck erwecken, menschliche Kommunikationspartner zu sein, und einst spezifisch menschliche Geistesarbeit zu ersetzen drohen.1 Auf einfache oder komplexe Fragen produzieren sie in Sekundenschnelle Antworten, bei denen wir nur noch mit großer Mühe, wenn überhaupt, erkennen können, dass sie nicht von einem Menschen stammen. Da sie im Prinzip auch alle erdenklichen historischen Fragen beantworten, macht sich in der Geschichtswissenschaft eine existenzielle Verunsicherung breit. Was können Historiker*innen, was Maschinen nicht schneller und (bald) besser können? Wie kann und muss das Fach unter den Bedingungen Künstlicher Intelligenz betrieben und unterrichtet werden?
Die Diskussion um die Nutzung generativer KI in den Geschichts-, Geistes- und Kulturwissenschaften hat gegenwärtig drei Stränge. Erstens geht es um den Einsatz von KI zur Formulierung wissenschaftlicher Texte, wobei sich die hochschulpolitische Diskussion, wenigstens im deutschen Sprachraum, besonders auf die Frage konzentriert, wie ganz oder teilweise KI-generierte Haus- und Abschlussarbeiten zu bewerten seien.2 Zweitens eruieren Historiker*innen in praxisnahen Abhandlungen die neuen Möglichkeiten, KI-Modelle zur Erschließung und Auswertung von großen Datenmengen einzusetzen.3 Drittens geht es um die kritische Reflexion der Nutzung von KI-Modellen in den historischen Wissenschaften. Zu dieser wollen wir beitragen, indem wir im Folgenden genauer nach den epistemologischen und forschungsethischen Konsequenzen des KI-Einsatzes zur Recherche und Ordnung von Wissen fragen.4 Dabei argumentieren wir, dass die Entwicklung der KI nur die vorerst letzte Stufe einer grundlegenden Wissenstransformation im digitalen Zeitalter ist.5 Diese begann mit dem Einsatz von Computern und Datenbanken um die Mitte des 20. Jahrhunderts, in dessen Folge die traditionellen Klassifikationssysteme des Wissens sukzessive an Bedeutung verloren.6 Wir begreifen dieses vermeintliche Ende der Systematik als einen tiefgreifenden Wandel der Wissensproduktion, den es ins Zentrum der methodisch-theoretischen Reflexionen des Fachs wie der Geistes-, Kultur- und Sozialwissenschaften insgesamt zu stellen gilt. Während die KI einerseits beeindruckende Möglichkeiten eröffnet, verdunkelt sie andererseits die Prozesse der Wissensklassifikation und erschwert die Klassifikationskritik, die wesentliche Bestandteile historischen Arbeitens sind und bleiben müssen.
1. Medienwandel und Zeitgewinn:
Literaturrecherche vom Zettelkasten zum OPAC
Wer im 20. Jahrhundert mit dem Studium der Geschichtswissenschaft begann, musste in den ersten Semestern das sogenannte historische Handwerkszeug erlernen: die Recherche in Handbüchern und Lexika sowie das systematische und unsystematische Bibliographieren von wissenschaftlicher Literatur.7 Die Studierenden sollten die Fähigkeit gewinnen, möglichst schnell und präzise Wissensressourcen über die Vergangenheit zu erschließen und das eigene Vorwissen mit der vorhandenen Literatur abzugleichen, zu differenzieren und zu erweitern. Um die eigenen Überlegungen auf wissenschaftliches Niveau zu heben, war es unerlässlich, allgemeine und spezielle Bibliographien sowie systematische Bibliothekskataloge zu konsultieren, die sich hierzulande noch im ausgehenden 20. Jahrhundert oft in großen Zettelkästen befanden. Genauso wie beim Nachschlagen in Lexika und Handbüchern war es auch beim Bibliographieren entscheidend, sich zu überlegen, unter welchen Rubriken der Klassifikationssysteme die Publikationen zum eigenen Forschungsinteresse wohl verzeichnet sein könnten.
Wissenschaftliches Recherchieren bedurfte also der Nutzung und Reflexion systematischer Wissensordnungen. Reichte es, nach Titeln zu einer Epoche zu suchen (Kaiserreich, Weimarer Republik, Nationalsozialismus etc.), oder musste auch epochenübergreifende Literatur zur Politik-, Wirtschafts-, Sozial- oder Kulturgeschichte erschlossen werden? Waren nur Titel wichtig, die sich auf ein Land bezogen, oder auch solche, die unter anderen Ländern oder vielleicht sogar Großräumen verzeichnet wurden? Reichte die Durchsicht fachspezifischer Bibliographien, oder musste man bei einem interdisziplinären Anliegen auch auf Literaturzusammenstellungen anderer Fächer zurückgreifen? Wer zu Themen wie der Geschichte des Osmanischen Reiches im 18. Jahrhundert arbeitete, musste etwa wissen, wo diese Geschichte in Bibliotheken und Archiven überhaupt zu finden war: unter »Europa« und/oder »Asien«, bei Islamwissenschaft, Orientalistik und/oder Osteuropäischer Geschichte? Wissen, so lernten Studierende vom ersten Semester an, war nicht einfach vorhanden, sondern war in institutionellen, sprachlichen und materiellen Formen erzeugt und abgelegt worden. Disziplinen und Subdisziplinen differenzierten sich in Zeitschriften und Publikationsreihen aus, die boundary work betrieben und definierten, was als wissenschaftliches Wissen gelten durfte. Wissenschaftliche Arbeit begann daher weniger mit der Lektüre einzelner Texte, sondern vielmehr damit, die Topographie des Wissens zu erschließen. Bei der Recherche waren Studierende und Forschende gezwungen, sich mit der kanonisierten Systematik des Wissens über die Welt und der langen Geschichte dieser Systematik auseinanderzusetzen.
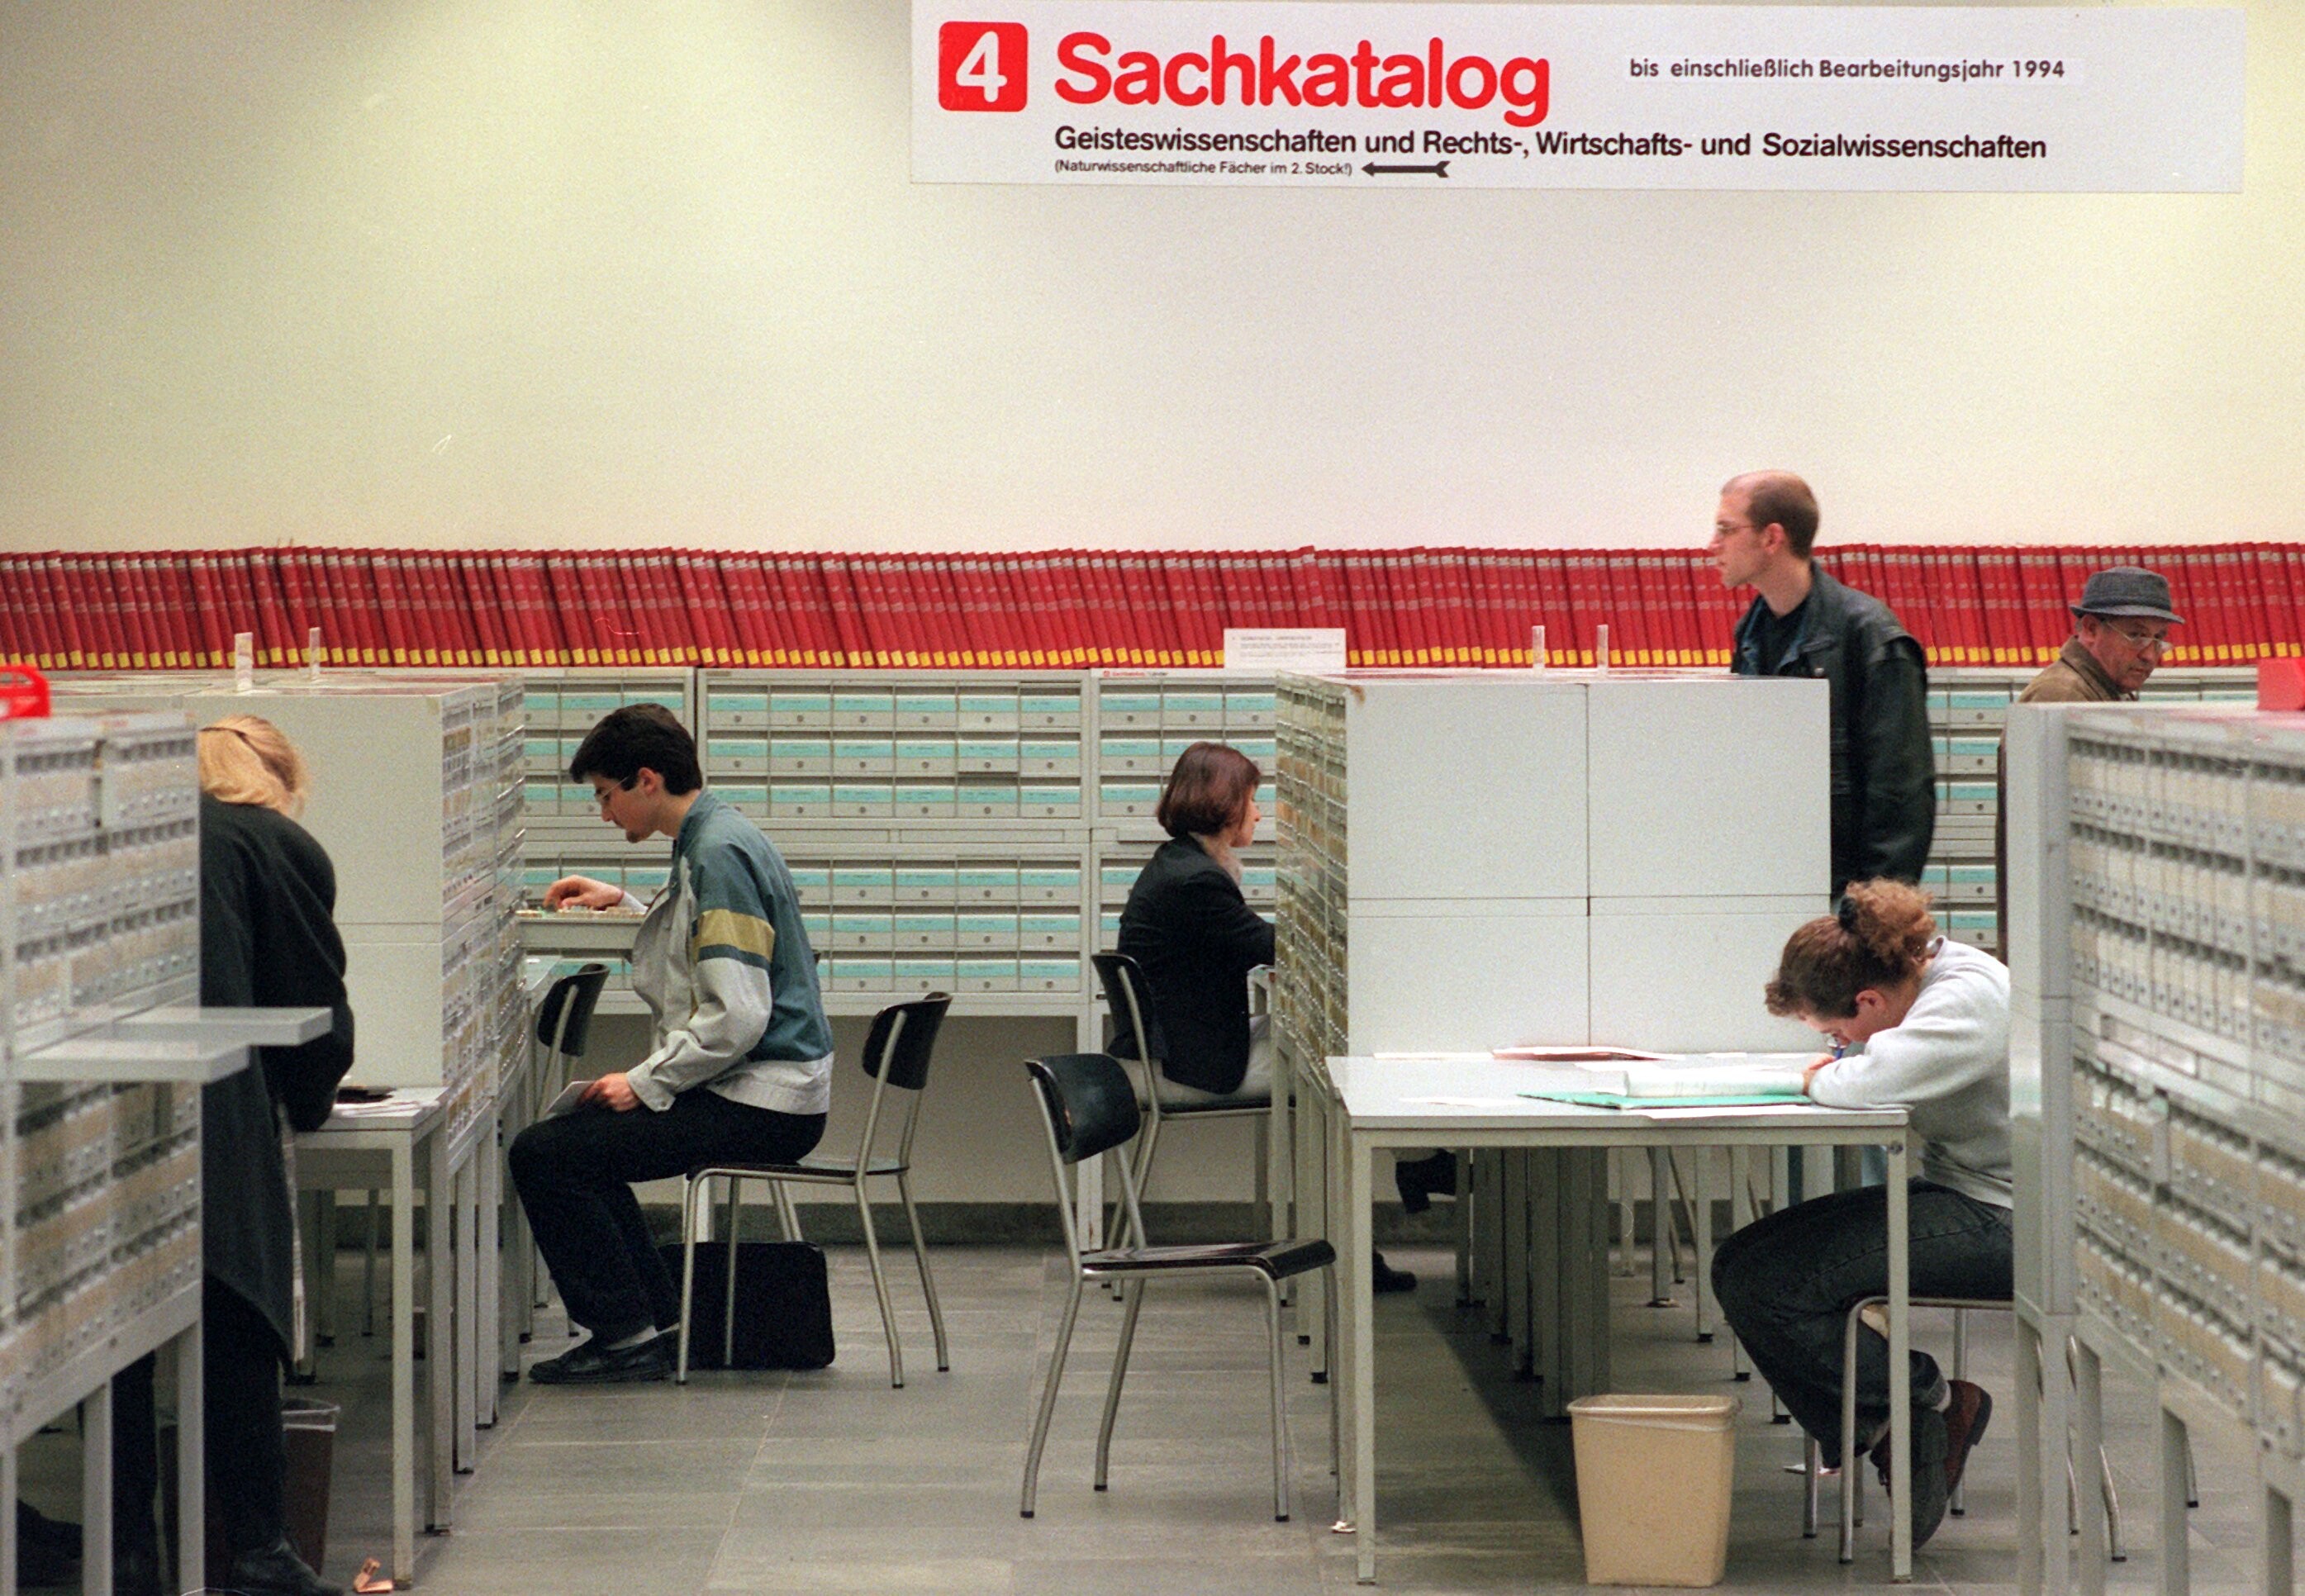
hier noch auf analogen Wegen
(picture-alliance/dpa/Oliver Berg)
Seit dem Ende des 20. Jahrhunderts hat sich die Situation grundlegend gewandelt. Die Digitalisierung hat Möglichkeiten eröffnet, Informationen über die Vergangenheit zu recherchieren und zu erschließen, ohne vorab die überkommene Einteilung des Weltwissens in Epochen, Regionen, Funktionssysteme oder disziplinäre Zusammenhänge zu erlernen. Niemand muss heute mehr wissen, dass die Arbeitslosenzahl zu den zentralen Wirtschaftsindikatoren gehört, von statistischen Ämtern erhoben wird und primär in deren periodischen Publikationen oder sekundär in den zusammenfassenden Darstellungen von Wirtschaftshistoriker*innen zu finden ist, um die Information zu erhalten, wie viele Menschen 1932 in Deutschland arbeitslos waren. Genauso wenig muss man sich heute noch in einer Bibliothek zurechtfinden oder gar »Keesings Archiv der Gegenwart« kennen, um in sehr kurzer Zeit einen Eindruck davon zu gewinnen, wie bestimmte historische Ereignisse im 20. Jahrhundert zeitgenössisch wahrgenommen wurden. Wir haben in nur wenigen Jahren den Bedeutungsverlust der systematischen Klassifikation des historischen Weltwissens erlebt. Dessen Erschließung ist schneller, vielfältiger und ungeordneter möglich geworden: wilder, mit allen positiven und negativen Konnotationen. Welche Chancen und Gefahren liegen darin, dass geschichtliches Wissen nun erschlossen und neu generiert werden kann, ohne sich mit der systematischen Ordnung zu beschäftigen, die Generationen von Wissenschaftler*innen, Bibliothekar*innen und Archivar*innen erdacht, erlernt, kritisiert und weiterentwickelt haben? Was bedeutet die Verwilderung des Wissens für die fachlichen Diskussionen und die Lehre?
Die grundstürzende Veränderung der historiographischen Recherchepraxis begann mit der Verbreitung von Online Public Access Catalogues (OPACs) in Bibliotheken seit dem Ende der 1970er-Jahre. OPACs eröffneten andere Suchmöglichkeiten als diejenigen, die von den systematischen Klassifikationen vorgegeben wurden. Mit Booleʼschen Operatoren konnten die verschiedenen Felder der klassischen Bibliothekskarteikarte verknüpft und so Suchstrategien jenseits der Systematik entwickelt werden. Dahinter verbarg sich der allgemeine Siegeszug relationaler Datenbanken, die sich in den USA durchzusetzen begannen und einen demokratischeren Wissenszugang versprachen. Sie rückten die Nutzer*innen ins Zentrum. Fortan war es nicht mehr notwendig, die Struktur der Datenbank zu kennen, die sich aus dem Programmcode ergab. Um durch das Labyrinth des Datenraumes zu navigieren, reichte nun das Wissen um die Logik der Verknüpfungen von Daten aus, die sich beliebig kombinieren ließen. Kenntnisse über die Hierarchie der Datenablage waren nicht mehr nötig. Dieses Blackboxing der zugrundeliegenden Topologie der Daten hatte der am IBM Research Laboratory in San José arbeitende britische Mathematiker Edgar F. Codd bereits 1970 emphatisch als Emanzipationsleistung begriffen: »Future users of large data banks must be protected from having to know how the data is organized in the machine.«8 In der einprägsamen Formulierung des Technikhistorikers David Gugerli vollzog sich hiermit »auf der User-Seite der Datenbank ein Übergang von der gezielten Suche nach abgespeicherten Daten hin zur generalisierten Abfrage von Datenbankbeständen, also ein Übergang von der Recherche zur Befragung des Orakels«.9
Traditionell stellten Bibliotheken ihre Bestände auch in dieser Phase noch nach einer inhaltlichen Systematik auf und folgten dabei meist der Universellen Dezimalklassifikation (UDK), die am Ende des 19. Jahrhunderts als mehrsprachige Variante aus der in den 1870er-Jahren entstandenen Dewey Decimal Classification (DDC) hervorgegangen war. Im deutschen Sprachraum war die Regensburger Verbundklassifikation (RVK) noch Mitte der 1960er-Jahre als Alternative entstanden. Aufgrund der Wissensexplosion, die sich in der dynamischen Zunahme der Buch- und Textproduktion im 20. Jahrhundert niederschlug, begannen große Bibliotheken jedoch, von der systematischen Aufstellung abzurücken und Bücher nach Eingang aufzustellen.10 Diese Numerus-Currens-Magazinierung entkoppelte die systematische Ordnung der Bestände von der physischen Ordnung in den Regalen und machte Karteikästen zum zentralen Ordnungsmedium. Über deren Verschlagwortung wurden die Inhalte der Bibliotheksbestände zueinander relationiert und erschließbar.11 Ab den 1970er-Jahren brauchten die Nutzer*innen in den USA dementsprechend oft kein Wissen mehr über die Architektur des Gebäudes, die »Hardware« der Regale, sondern nur noch über die »Software«, d.h. die Systematik der Schlagworte, um historisches Wissen aus den Beständen zu generieren. Auch in bundesdeutschen Universitätsbibliotheken begann sich dies um 1990 durchzusetzen.
2. Vernetzung und Hierarchieverlust: das World Wide Web
Nichtsdestoweniger blieb die Systematik, nach der die Bücher verzeichnet wurden, auch weiter ein wesentliches Element im Rechercheprozess. Zumindest wurde Studierenden in geschichtswissenschaftlichen Proseminaren der Unterschied zwischen der Stichwortsuche über Titel und der Schlagwortsuche eingebläut, die je verschiedene Ergebnisse erzielten. Darüber hinaus war wichtig, dass ein OPAC immer nur die selbstständigen Publikationen im Bestand einer bestimmten Bibliothek verzeichnete. Selbst wenn es sich um die Deutsche Nationalbibliothek (bzw. 1990–2006: Die Deutsche Bibliothek) oder um die Library of Congress handelte, konnte die Suche im Bibliothekskatalog die Recherche in systematisch geordneten Bibliographien also nicht ersetzen. Die Lage änderte sich jedoch, als Bibliothekskataloge zu Verbünden vernetzt und über eine gemeinsame Suchmaske erschlossen wurden.
Bereits lange vor der Entstehung des World Wide Web hatte es erste Vorhaben von Bibliotheken gegeben, Computer zur Katalogisierung zu nutzen und Datensätze über ein gemeinsames Computernetz zu teilen, etwa im 1967 in Ohio gegründeten und bis heute bestehenden Online Computer Library Center (OCLC). Die Automatisierung und Digitalisierung wissenschaftlicher Bibliotheken avancierte in der Folge zu einem Ziel bibliothekarischer Anstrengungen, das bisweilen geradezu utopisch anmuten konnte.12 Der Computerpionier J.C.R. Licklider übersetzte den Traum eines elektromechanischen Informationssystems, den Vannevar Bush bereits 1945 in seinem berühmten Artikel »As We May Think« beschrieben hatte, 1965 in sein Buch »Libraries of the Future«.13 Im Einklang mit Überlegungen zur Symbiose von Mensch und Maschine setzte Licklider auf ein an den individuellen Fragen der Nutzer*innen orientiertes System: Wenn man sich Wissensaneignung als einen dynamischen Prozess vorstelle, der aus dem wiederholten Abgleich vieler kleiner Fragmente und einzelner Daten bestehe, stoße jedes Konzept einer Bibliothek, das von einer starren Ordnung des Wissens in Form von Büchern in Regalen ausgehe, unweigerlich an seine Grenzen.14 Emphatisch forderte Licklider daher, dass Bibliothek und Computer verschmelzen müssten: »We need to substitute for the book a device that will make it easy to transmit information without transporting material, and that will not only present information to people but also process it for them, following procedures they specify, apply, monitor, and, if necessary, revise and reapply. To provide those services, a meld of library and computer is evidently required.«15 Das neue, von Licklider propagierte »prokognitive System« sollte das Ordnungsschema der physischen Bibliothek, also »the arrangement of shelves, card indexes, check-out desks, reading rooms, and so forth«, durch einen datenbankbasierten, inhaltsadressierbaren Speicher ersetzen, der direkte, auch parallele Zugriffe erlaubte (etwa über Terminals). Auf diese Weise sollte der Rechercheraum zugleich erweitert, pluralisiert und individualisiert werden.
Es dauerte, bis diese Vision real wurde. Zwar nutzten Verbünde wie OCLC in den USA eigene Computernetze, um Daten elektronisch auszutauschen, doch war der Zugang zu Beginn nur lokal an Terminals in den Bibliotheken möglich. Dies änderte sich durch Verbundzentralen und gemeinsame Datenbanken in den 1980er- und 1990er-Jahren, als auch der akademische Austausch über das Netz zunahm. 1997 stand der 87. Deutsche Bibliothekartag unter dem Motto »Von Gutenberg zum Internet«.16 Im Jahr zuvor war der Karlsruher Virtuelle Katalog (KVK) im World Wide Web freigeschaltet worden, der die Recherche über so viele Bibliothekskataloge gleichzeitig ermöglichte, dass sich die Suche in der Deutschen Nationalbibliographie erübrigte. Zudem entstanden Zeitschriftendatenbanken wie JSTOR (1994), die wissenschaftliche Aufsätze aus vielen Fachgebieten digital erfassten. Damit veränderte sich die Recherche von Zeitschriftenaufsätzen, die zuvor mühsam über Bibliographien und deren Systematik hatten erschlossen werden müssen, ebenso grundlegend wie die Buchrecherche durch die OPACs. Zwar konnte in den Zeitschriftendatenbanken weiter entlang der traditionellen Klassifikation mit Schlagworten gesucht oder die Recherche auf bestimmte Fachgebiete beschränkt werden. Daneben ermöglichten die neuen Datenbanken aber die Volltextsuche sowohl über die Abstracts, wenn diese vorhanden waren, als auch über die Volltexte der digitalisierten Zeitschrifteninhalte.17 So eröffneten sie einen wesentlich gezielteren Zugriff auf Wissensbestände, ohne dass sich die Nutzer*innen damit beschäftigen mussten, in welchen Forschungs- und Klassifikationszusammenhängen die Aufsätze bisher entstanden und verzeichnet worden waren. Bibliotheken wiederum konnten nun – auch im Zuge der beginnenden Digitalisierung größerer Buchbestände – in ihren Katalogen nicht mehr nur selbstständige Publikationen nachweisen, sondern auch Beiträge aus Zeitschriften und Sammelbänden. Auf diese Weise wurden Bibliothekskataloge zu eigenständigen, interdisziplinären Rechercheportalen umgeformt.
Generell expandierten seit den 1990er-Jahren mit dem World Wide Web die digital bereitgestellten Wissensressourcen erheblich. In Seminaren wurden zunächst Link-Kataloge zu wissenschaftlich hilfreichen Websites verteilt. Allgemeine Suchmaschinen halfen zudem, die vielfältigen Ressourcen zu erschließen, und wurden dabei immer besser, indem sie die Suchergebnisse an die von ihnen gespeicherten Präferenzen der Nutzer*innen anpassten.18 Wer in der zweiten Hälfte der 1990er-Jahre studiert hat, mag sich noch daran erinnern, wie auf den Universitätsfluren der Tipp kursierte, man solle mal Google ausprobieren, es liefere viel bessere Ergebnisse als etwa Yahoo. Zugleich warnten Professor*innen Studierende noch in den frühen 2000er-Jahren allenthalben davor, bei der Recherche zu googeln, und verwiesen auf die Fehlerlastigkeit von Wikipedia und anderen Online-Angeboten. Sie rieten den Studierenden, sich bloß auf nichts zu verlassen, was sie dort lesen konnten, und stattdessen weiter die klassischen Nachschlagewerke, Lexika und Handbücher zu konsultieren. Diese Empfehlungen waren allerdings schnell obsolet. Die schiere Masse des in Wikipedia zusammengetragenen Wissens wurde so groß, dass niemand mehr darauf verzichten konnte. Trotz aller Probleme stellte die Online-Enzyklopädie eine Menge an Informationen in einer Detailfülle bereit, mit der keine der klassischen Enzyklopädien mithalten konnte. Zugleich bot sie das Wissen aber enthierarchisiert, weniger systematisch und insgesamt wilder dar. Ob eine Person, ein Gegenstand oder ein Ereignis einen Eintrag erhielt und wie lang und detailliert diese Artikel angelegt wurden, hing zunächst vom Interesse der freiwillig und unbezahlt Schreibenden ab – nicht von der Entscheidung einer Redaktion. Die komplexe Verlinkung zu weiteren Wissensressourcen im Netz ermöglichte es, in unzählige Richtungen weiterzulesen. Google nicht zu nutzen und Wikipedia zu meiden, wurde im Verlauf eines Studiums von einem weisen zu einem törichten Rat. Ein erfolgreiches Geschichtsstudium ohne Computer war zur Jahrtausendwende unmöglich geworden.
3. Geschwindigkeit und Kontextverlust:
die servile Dienstbarkeit der LLMs
Seit in den letzten Jahren KI-Abfragen auf der Basis großer Sprachmodelle möglich geworden sind, ist eine ähnliche Diskussion entstanden wie bei der Einführung der Suchmaschinen vor einem Vierteljahrhundert. Auch heute warnen manche Historiker*innen kategorisch vor der Nutzung und führen mehr oder weniger lustige Halluzinationen als abschreckende Beispiele an. Andere sind offener und experimentieren mit verschiedenen KI-Tools, um die eigene Arbeit zu verbessern.19 Auf einem Podium in der Berlin-Brandenburgischen Akademie der Wissenschaften erläuterte etwa kürzlich ein führender Zeithistoriker der emeritierten Generation, Perplexity erziele bessere Recherche-Ergebnisse als ChatGPT. Entscheidend sei die Präzision der Prompts. Um zu illustrieren, wie man diese formulieren müsse, griff er dann allerdings auf seine profunde Kenntnis der systematischen Wissensklassifikation zurück, die er im Studium erlernt und danach jahrzehntelang gelehrt hatte.
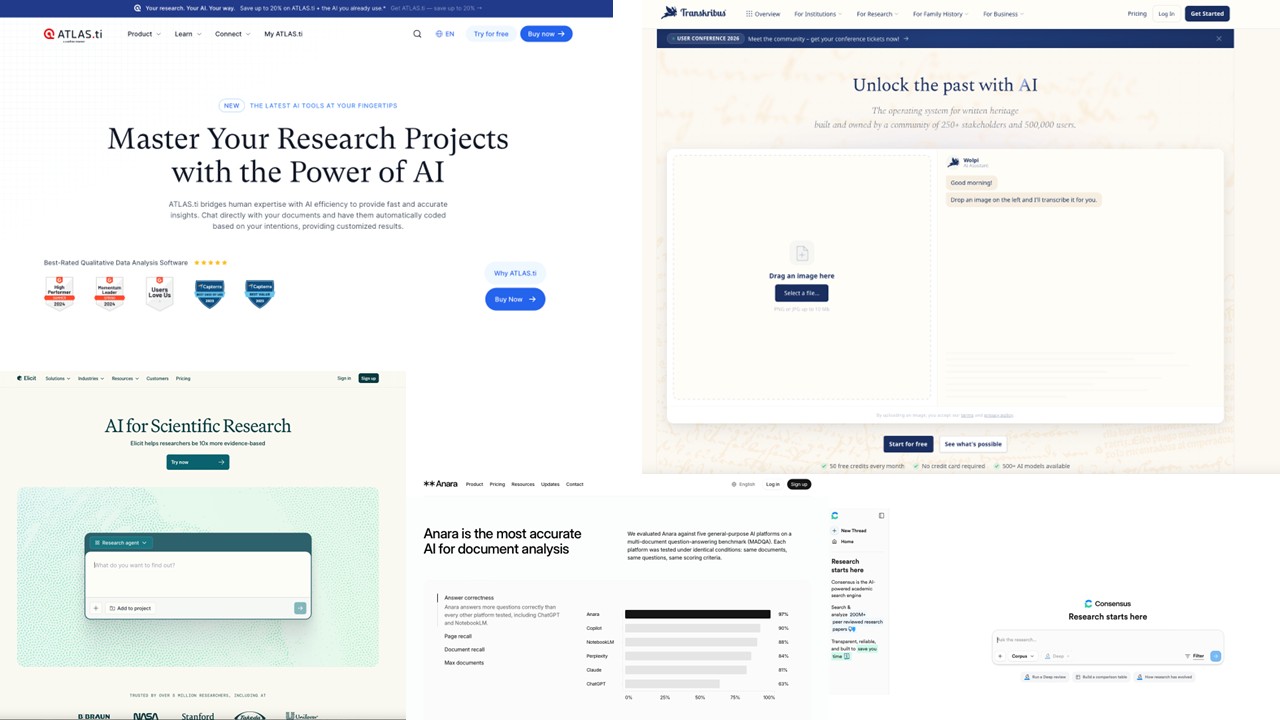
teils auch direkt zugeschnitten auf geisteswissenschaftliche Arbeitszusammenhänge,
etwa die Transkription handschriftlicher Quellen.
(Collage: Michael Homberg)
Im Prozess der historiographischen Recherche und Wissenserschließung, um den es uns im Folgenden primär geht, können KI-Tools an verschiedenen Stellen eingesetzt werden.20 Erstens kann man die KI beim Bibliographieren zu bestimmten Themen, Fragen oder Forschungskontroversen nutzen. Mit passenden Prompts liefern Sprachmodelle gerade für kanonische Themen wie zum Beispiel die Sonderwegs-Debatte, die Krisendynamiken der Weimarer Republik oder die Faktoren, die zum Aufstieg des Nationalsozialismus führten, zentrale Monographien, die außerdem durch Kommentare und Bemerkungen zur Wirkungsgeschichte erschlossen werden. Das geht schneller als eine klassische Recherche und ist hilfreich für einen ersten Einstieg, wenn man sich nicht auskennt. Um genauere Ergebnisse zu erzielen, muss man dann allerdings in der Regel bereits viel über den Gegenstand, den Gang geschichtswissenschaftlicher Debatten, abweichende Forschungsperspektiven und disziplinäre Publikationsmechanismen wissen.21 Gerade weil die Literaturrecherche mit KI-Tools »intelligent« sein will, also die wichtigsten Titel und keine überbordende Fülle auch irrelevanter Texte anzugeben beabsichtigt, wie sie in einer Schlag- oder Stichwortsuche enthalten wären, ist sie dieser vor allem zum Einstieg überlegen. Im weiteren Rechercheprozess kann sich dieser Ansatz jedoch auch nachteilig auswirken – zum einen, weil die Suche ein voraussetzungsreicher Prozess bleibt, die hohe Soliditätssuggestion der erläuternden Einordnung aber gerade bei Studierenden das Vertrauen in die Resultate befördern dürfte. Zum anderen reduzieren die algorithmischen Auswahlentscheidungen die Möglichkeit, vermeintlich abwegige, selten zitierte Zufallstreffer zu ermitteln und diese eigenständig zu rezipieren.
Zweitens lassen sich KI-Tools nutzen, um das eigene Vorwissen zu stabilisieren. Sie übernehmen dann die Funktion, die bislang Handbüchern und Lexika zukam. Auch hier zeigen sich indes Verzerrungen, die sowohl aus den Prompts der Nutzer*innen als auch aus der Datenbasis der LLMs resultieren können. So überakzentuierte etwa das LLM Kimi K3 bei dem Versuch, Schwerpunkte, Trends und Desiderate der Forschung zur Geschichte des digitalen Zeitalters zu skizzieren, die Forschungslücken im Feld, wobei zentrale Arbeiten zur Sozial- und Alltagsgeschichte, zur Geschlechtergeschichte oder auch zur Globalgeschichte des digitalen Wandels unterschlagen wurden. Bei genauerem Nachhaken konzedierte die KI, erkennbar um ein Echo der Kritik bemüht, »existierende Forschungsstränge systematisch marginalisiert« zu haben und die »Kanonbildung« zu reproduzieren. Sie »entdeckte«, einschließlich einiger Halluzinationen, wichtige Studien der vergangenen Jahre. Schlüsselwerke vorheriger Dekaden, die im Netz weniger Spuren hinterlassen hatten, blieben indes weiter außen vor. Zudem prägte die Ausgangssprache der Prompts erkennbar die Ergebnisse, die mal vorrangig die deutschsprachige und mal eher die anglophone Literatur abbildeten.22 Auch hier erweist sich also gerade die Voraussetzungslosigkeit und Einfachheit der Recherche als zweischneidiges Schwert.
Drittens können KI-Tools genutzt werden, um konkrete, empirische Fragen zu beantworten, die im Arbeitsprozess auftauchen. Hier überzeugen sie bisweilen durch sehr schnelle und präzise Antworten, wenn man zum Beispiel wissen will, welche FDP-Abgeordneten im Zuge der Auseinandersetzung um die »Neue Ostpolitik« die Bundestagsfraktion verließen.23 Auch wenn eine kritische Überprüfung der Ergebnisse stets notwendig bleibt, wäre in diesem Fall die inzwischen klassische Google-Suche mit gleichem Ziel viel komplizierter und langwieriger gewesen. Diese ist schließlich nicht »intelligent«, sondern lenkt auf Wikipedia-Einträge und andere Webseiten, welche die Suchbegriffe enthalten. Dabei handelt es sich um Texte, die einem anderen Anliegen folgen als dem eigenen Frageinteresse. So stößt man etwa auf längere Artikel zur Deutschlandpolitik in den 1970er-Jahren, auf digitalisierte Sitzungsprotokolle des Deutschen Bundestages und weitere Quellen zur Geschichte der sozialliberalen Koalition im Netz, die man wiederum durchsuchen oder lesen müsste, um die eigene Frage zu beantworten. Mit anderen Worten, LLMs ermöglichen es den Nutzer*innen, historisches Wissen zu erschließen, ohne sich durch traditionelle Wissensklassifikationen, überkommene Systematiken und Präsentationsweisen, also die Relevanzstrukturen etablierter Disziplinen und ihrer Erkenntnisinteressen, hindurchwühlen zu müssen. Sie sind nicht so widerspenstig wie frühere Rechercheinstrumente.
Die Beispiele zeigen, dass die servile Dienstbarkeit der LLMs, die inzwischen als »Sycophancy Effect« diskutiert wird, gravierende Probleme in sich birgt und ihre wissenschaftliche Nutzung nur vermeintlich intuitiv, in Wahrheit aber überaus voraussetzungsreich ist. Nichtsdestoweniger ist die Geschwindigkeit, mit der KI-Modelle sehr präzise Informationen unabhängig von deren bisheriger Speicherung bereitstellen können, zunächst einmal ein Gewinn. Sie können ansonsten langwierige und langweilige Arbeitsschritte erheblich erleichtern und zu besseren Ergebnissen führen. So kann etwa die Prüfung eines eigenen Textes auf der Grundlage definierter Datenbanken und Retrieval-Augmented Generation (RAG), wenn man die LLMs nach faktischen Fehlern oder Unstimmigkeiten, übersehener Literatur oder weiteren Aspekten bzw. relevanten Diskussionssträngen suchen lässt, in kurzer Zeit beeindruckende Ergebnisse erzielen, die den eigenen historiographischen Assoziationsraum beträchtlich erweitern und den Text substantiell verbessern können. Aber geht auch etwas verloren, wenn man sich bei der Erschließung historischen Wissens und der Beantwortung historischer Fragen immer weniger mit etablierten Wissensbeständen, ihrer Entstehungslogik sowie der Systematik ihrer Überlieferung und Präsentation auseinandersetzen muss? Gibt es auch Nachteile, wenn man sich nicht mehr daran abarbeiten muss, dass die Gegenstände, mit denen man sich beschäftigt, von früheren Generationen auf eine bestimmte Weise klassifiziert worden sind, die oft nicht deckungsgleich mit den eigenen Interessen und Fragen ist? Was bedeutet es, dass man sich, um bestimmte Antworten zu erhalten, nicht mehr durch Berge von anscheinend nutzlosem Wissen kämpfen muss?
Der Weg zur gewünschten Information war früher zwar beschwerlicher, aber auf ihm lernte man sehr viele Dinge, die dabei halfen, die schließlich gewonnenen Informationen einzuordnen und zu interpretieren – eine Funktion, die jetzt die KI übernehmen soll. Alle, die schon einmal in einer Bibliothek mit systematischer Aufstellung gearbeitet haben, dürften die Erfahrung gemacht haben, dass ihr Blick auf der Suche nach einem bestimmten Buch an einem anderen Titel hängenblieb, der zuvor durch ihr Suchraster gefallen war, am Ende aber viel wichtiger für ihre Arbeit wurde. Allein die physische Gestalt des Buches, des Zeitschriftenheftes, der regierungsamtlichen Publikation oder der Flugschrift vermittelte diverse Informationen, bevor überhaupt ein Wort ihres Inhalts gelesen wurde. Bei der Arbeit an digitalen Endgeräten gehen viele davon verloren. Schon die Entmaterialisierung der Bücher und Zeitschriften bzw. die Nivellierung ihrer physischen Differenz auf der einheitlichen digitalen Benutzeroberfläche führt zu einer stärker eklektisch angelegten Lektüre: Der Gesamtzusammenhang des Textes, seine Paratexte und Entstehungszusammenhänge treten in den Hintergrund. Handelt es sich dabei um eine Befreiung von unnötigem Ballast oder sogar von gefährlichen, weil machtdurchtränkten Einflüssen? Wer konnte immerhin schon früher ein imposantes Buch publizieren, welche eigentlich innovativen Texte scheiterten an disziplinärer boundary work? Werden also mit der Verwilderung des Wissens eher Deutungsräume geöffnet und historiographische Kreativitätspotentiale freigesetzt? Oder gehen entscheidende Leitplanken des historischen Denkens verloren, welche die Fachdiskussion überhaupt erst ermöglicht haben?
Die Ordnungsleistung der KI vollzieht sich in Form statistischer Verdichtung: Sprachliche Einheiten – Wörter, Satzteile, ganze Dokumente – werden in numerische Repräsentationen übersetzt, die statistisch erlernte Merkmalsunterschiede im Sprachgebrauch reflektieren und entlang von Ähnlichkeitsrelationen gewichten. Was zusammengehört, ist nicht mehr durch explizite Kategorien definiert, sondern durch die Nähe in einem multidimensionalen Vektorraum. In diesem geometrischen Raum, der Milliarden von Datenpunkten besitzt, werden Richtungsähnlichkeiten von Wörtern berechnet, die sich aus den Verwendungsmustern ergeben. »Arbeiter« und »Angestellte« liegen hier in aller Regel näher beieinander als »Arbeiter« und »Liebesbriefe«, da sie in ähnlichen Sätzen erscheinen und analoge Funktionen erfüllen. An die Stelle der klassischen, baumartigen Taxonomie tritt also eine komplexe topologische Ordnung. Diese Form der Ordnung ist in den neuen Modellen dynamisch und graduell, kurzum: eine kontextabhängige Funktion.24
Auch wenn die Modelle Korrektive durch menschliches Feedback erlauben, zeigen sich doch weiter epistemische »Pfadabhängigkeiten«. So bleibt die KI durchaus an Systematiken gebunden, die aus historisch gewachsenen Wissensordnungen stammen. Trainingsdaten reproduzieren disziplinäre Grenzziehungen, kanonische Narrative, hegemoniale Perspektiven, machen dies aber in aller Regel gerade nicht explizit. Da der Vektorraum ein mathematischer Abdruck des Trainingsmaterials ist (also eines Teils unseres kulturellen Archivs), reproduziert er historische Vorurteile.25 In diesem Sinne markiert die generative KI also keine Zäsur. Vielmehr aggregieren die Algorithmen, auch im Modus des maschinellen Lernens, was bereits sagbar war – und verstärken dadurch Muster und Ordnungen, die sich in den Daten sedimentiert haben. So scheint die Souveränität der Forschenden erhalten zu bleiben und sogar noch gesteigert zu werden, wenn die KI-Tools eilfertig präzise Antworten auf alle erdenklichen Fragen bereitstellen und dabei vermeintlich unnütze Informationen weglassen. Tatsächlich wird sie aber eingeschränkt, weil solche Antworten den Zugang zu den ursprünglicheren Topographien der Wissensproduktion verstellen. Die KI befreit nur scheinbar vom Kategorienwissen, denn Prompts sind hochgradig strukturierte Operationen, durchzogen von impliziten Vorannahmen, begrifflichen Setzungen und disziplinären Rahmungen.
Mit Michel Foucault könnte man KI als ein Dispositiv begreifen, das Wissen produziert, ordnet und zugleich die Bedingungen seiner Sagbarkeit reguliert. Der entscheidende Unterschied zur klassischen Bibliothek besteht nicht in der Abwesenheit von Ordnung, sondern vielmehr darin, dass diese unsichtbar gemacht und damit weniger kritisierbar wird. Der epistemische Schock, der angesichts des Vordringens von KI in den Geisteswissenschaften gegenwärtig zu beobachten ist, hat seinen präzisesten Sinn darin, dass wir eine neue digitale Ordnung der Worte und Dinge erleben, die sich von unseren bisherigen Formen des Denkens sowie dem Transparenzanspruch akademischer Kategorienbildung zu lösen beginnt und uns dadurch – wie in der berühmten Eingangsszene moderner Erkenntniskritik in Foucaults »Ordnung der Dinge« – plötzlich damit konfrontiert, dass die zusehends verborgenen Ordnungen des Wissens letztlich auch ganz anders aussehen könnten.26
Einer kulturkritischen Perspektive, die im Vordringen von KI die Erosion epistemischer Widerstände entdeckt, ließe sich aber auch eine positivere Deutung entgegenhalten. Das Formulieren von Prompts kann als Schule der epistemischen Selbstreflexion, als Resonanzraum des Denkens begriffen werden, in dem sich Hypothesen testen, Argumente zuspitzen und blinde Flecken sichtbar machen lassen. Die Zukunft des wissenschaftlichen Arbeitens wird daher wohl kaum darin liegen, zwischen »traditioneller« Recherche und KI-Nutzung zu wählen, sondern eher darin, beide Modi zu verschränken. Die langsame Lektüre, die Arbeit am Material, das Verständnis historischer und systematischer Kontexte, auch die Serendipität der Funde, die im Bibliothekskatalog, am Regal und im Archiv erfolgen, bleiben nicht trotz, sondern gerade wegen der neuen Technologien unersetzlich. Ohne sie würde das implizite Kategorienwissen verlorengehen, das notwendig ist, um die scheinbare »Offenheit« der KI sinnvoll zu strukturieren. Ein fachlich angemessener Einsatz der KI erfordert daher klassische Kategorienkenntnis und -bildung27 und muss durch ein Verständnis der digitalen Ordnungsleistung ergänzt werden. Dazu müssen die klassischen Kulturtechniken um eine kritische Promptologie als Hermeneutik der Eingabe erweitert werden: Neben der Interpretation von Texten werden die Reflexion der historischen Frage und ihre Übersetzung in KI-Prompts wichtiger werden. Das Bewusstsein für Modellgrenzen (Bias, Halluzination, Verluste von Kontexten) wird dabei ebenfalls bedeutsamer werden. Die »Macht« des besseren Prompts, im iterativen Dialog mit der Maschine, wird die Dynamiken der Wissensproduktion prägen. Es ist zwar noch nie so leicht gewesen, Informationen über die Vergangenheit zu erhalten, aber auch selten so anspruchsvoll, sie in historisches Wissen zu transformieren.
4. Perspektiven der Geschichtswissenschaft in der »KI-Ära«
Die Dynamiken der Digitalisierung haben die Arbeitsweise der Kultur- und Geisteswissenschaften in den vergangenen Jahrzehnten nachhaltig verändert; die angebrochene »KI-Ära« in den 2020er-Jahren markiert dabei eine neue, besonders bewegte Periode. Inzwischen sind digitale Techniken, ganz gleich, ob wir eher Maschinenträumen oder -ängsten zuneigen und ob wir den Wandel als »revolutionär« bezeichnen oder nicht,28 ein wesentlicher Teil des geschichtswissenschaftlichen Arbeitens geworden. Der amerikanische Philosoph Benjamin Bratton hat 2024 – im Anschluss an das berühmte Modell der Schweizer Psychiaterin Elisabeth Kübler-Ross – »Five Stages of AI Grief« unterschieden: Verleugnung, Wut, Verhandlung, Depression und Akzeptanz.29 Für Historiker*innen mag das von ihm diagnostizierte Trauma die Erkenntnis bergen, dass generative KI ein neues Werkzeug ist, das die eigenen Grundkategorien von Evidenz und Überprüfbarkeit, Originalität und Objektivität in Frage stellt.30
Aktuell erscheint es eher abwegig, eine »Ersetzung« der Historiographie durch KI zu befürchten, wie es nach einer Microsoft-Studie vom Sommer 2025 über die Bedeutung Künstlicher Intelligenz in verschiedenen Berufsfeldern diskutiert wurde.31 Geschichtsschreibung ist nicht die mehr oder weniger passende Kompilation von Sätzen über die Vergangenheit, die Maschinen irgendwann besser, schneller und vollständiger leisten können als Menschen. Vielmehr handelt es sich um eine kontingente, offene, medien- und perspektivengebundene Praxis, mit der sich Menschen im Hier und Jetzt über ihre Vergangenheit verständigen.32 Wenn forschendes Verstehen den Kern der Geschichtswissenschaft ausmacht, wie Johann Gustav Droysen im »Grundriß der Historik« formuliert, dann ist es ein Prozess, der zwischen Menschen stattfindet: denjenigen, deren Erzeugnisse aus der Vergangenheit heute noch zugänglich sind, denjenigen, die sich früher bereits mit diesen oder ähnlichen Quellen beschäftigt haben, und denjenigen, die heute mit neuen Techniken und Verfahren anderen etwas über die Vergangenheit sagen wollen, um sich selbst und ihre Gegenwart im Lichte sich wandelnder Zukunftserwartungen besser zu verstehen.33
Die Klassifikationssysteme, mit denen Weltwissen geordnet und überliefert wurde, bildeten in diesem Verstehensprozess so etwas wie epistemische Brücken, über die ein Sinnzusammenhang zwischen vergangenen Lebenswelten und heutigen Forschungsinteressen hergestellt wurde.34 Verstehen ist kein divinatorischer Prozess des Sichhineinversetzens, sondern beruht auf sehr vielen Gemeinsamkeiten, die selbst dann noch vorliegen müssen, wenn wir die Differenz zwischen heutigen und vergangenen Perspektiven auf die Welt feststellen.35 Wesentliche Innovationen gingen in der Geschichtswissenschaft gerade von solchen Forschungsansätzen aus, die mit ihren Analysen auch die zeitgenössischen Klassifikations- und Ordnungssysteme in Frage stellten, sei es aus der Perspektive der Geschlechter-, Kultur-, Wissens- oder Umweltgeschichte. Was geschieht aber, wenn der historische Weltzugang primär über KI-Anfragen und ohne Kenntnis der überkommenen Klassifikationssysteme erfolgt, wie es von heutigen und künftigen Studierendengenerationen und Forscher*innen immer stärker zu erwarten ist? Wie wird die Kontinuität von Sinn- und Verständigungszusammenhängen gesichert, wenn die Wissenserschließung nicht mehr anhand überlieferter Klassifikationen erfolgt (die zwar ob ihrer zeitgebundenen, epistemischen Blindstellen kritikwürdig sein mögen, aber zugleich transparent und damit eben auch kritisierbar sind), sondern über KI-Tools auf der Basis intransparenter Algorithmen?
Davon ausgehend stellt sich die Frage, welche epistemischen Kosten mit der Zerlegung des historischen Quellenmaterials und der Forschungsliteratur in fluide Informationseinheiten verbunden sind. Schließlich ist die Unmittelbarkeit, mit der eine KI-Anfrage heute Antworten liefert, eine epistemische Fiktion. Sie blendet die Ordnungen aus, die wirksam sind: statistische Strukturen und Wahrscheinlichkeitsräume. Die Systematik, die bis dato im Katalog studiert werden musste, ist in die Modelle gewandert, die auf »Prompts« hin Antworten geben, ohne dass die zugrunde liegenden Gewichtungen und Ausschlüsse noch als solche erfahrbar wären. Die Systematisierung wird also nicht abgeschafft, sondern delegiert. An die Stelle der sichtbaren Ordnung der Bibliothek oder Enzyklopädie tritt die unsichtbare Ordnung des Modells.
Bleiben die Algorithmen der KI, die zentral für die gegenwärtige und zukünftige »Kultur der Digitalität« sind,36 eine Blackbox, lassen sie sich indes kaum verantwortungsvoll nutzen. Die Vision neuer, kollaborativer Verbindungen von Mensch und Maschine stellt das überkommene Bild von Historiker*innen als autonomen Schöpfer*innen eines »Werks« in Frage und zwingt uns dazu, über die Rolle der Geschichtswissenschaft in den zentralen Konflikten um die KI-Nutzung nachzudenken. Zugleich geben die Risiken der aktuellen Umwälzung, die, wie die Historikerin Jill Lepore vor Kurzem konstatierte, durchaus in einer »Regierung der Maschinen« münden könnte, Anlass zur kritischen Auseinandersetzung.37 Ob uns die KI in ihrer »sykophantischen« Gesinnung weiter »dienen« wird und wir uns dadurch letztlich in die selbstgewählte »Unmündigkeit« einer algorithmischen »Filterblasen-Existenz« überantworten, oder ob wir vielmehr einen produktiven, selbstbestimmten Umgang mit ihr erlernen werden, scheint derzeit offen. In jedem Falle aber müssen wir den Algorithmen, die unser Leben und Arbeiten prägen, mehr Beachtung schenken – und dazu werden wir in den kommenden Jahren gerade auch die Kooperation von KI-Ingenieur*innen und Historiker*innen benötigen.38
Bereits jetzt zeichnet sich allerdings ab, dass die Regulierung des Zugangs zum Maschinenraum der KI-Modelle ein Politikum ist, dessen Bedeutung über einzelne Fächer, die Geisteswissenschaften und das Wissenschaftssystem insgesamt hinausweist. Gegenwärtig nutzen einige wenige Digitalkonzerne ohne Rücksicht auf Urheberrechte und Datenschutz die Archive des menschlichen Wissens, um ihre Algorithmen zu trainieren, die sie gleichzeitig zu Betriebsgeheimnissen deklarieren. Dieses Wissen stellen sie dann wieder zur Verfügung, aber gegen Bezahlung und über Zugänge, die sie der gesellschaftlichen und politischen Kontrolle entziehen. Die Geschäftspraxis der Digitalkonzerne wirft grundlegende Fragen nach der Urheberschaft, den Modi und Beschränkungen einer Speicherung und Verbreitung von Wissen sowie dem Schutz unseres kulturellen Erbes auf. Hinzu kommen die Bedenken angesichts der horrenden ökologischen Kosten, die der Energiehunger der Technologie verursacht und gegen die sich erste Widerstandsbewegungen formiert haben.39
Während die Tech-Apologeten ihre Produkte als Werkzeuge zur Überwindung bestehender Asymmetrien anpreisen, erzeugen diese tatsächlich neue digitale Ungleichheiten, Hierarchien und Exklusionen, welche die Grundfesten der demokratischen Meinungsbildung und Entscheidungsfindung gefährden. Die »Big Five« der amerikanischen Tech-Industrie sowie ihre neue KI-Konkurrenz aus den USA und aus China übernehmen quasi-staatliche Funktionen; sie greifen damit potentiell tiefer in die Struktur der Öffentlichkeit ein, als dies selbst autoritären Regierungen je möglich gewesen ist.40 Daher ist ihre gesellschaftliche Kontrolle genauso nötig wie die Herstellung von Pluralität und Vielfalt. Die öffentliche Diskussion und Reflexion über das Machen von Geschichte, über Marginalisierungen und Hierarchien ist dafür entscheidend. So wird es auch weiterhin wichtig bleiben, sich mit den scheinbar veralteten Systematiken des Wissens vertraut zu machen, die uns in verwilderter Form in den Antworten der Large Language Models wieder entgegentreten. Die Fähigkeit, die Entstehung und Bereitstellung der uns umgebenden »Daten« zu verstehen, sie kritisch zu evaluieren sowie neue, alternative Weltzugänge und Wissensordnungen zu entwickeln, wird deshalb der vielleicht bedeutendste Beitrag der Geschichts- und Geisteswissenschaften zu einer gestärkten demokratischen Willensbildung sein.
Anmerkungen:
1 Vgl. Rüdiger Safranski, Die vierte Kränkung. Menschlicher Geist im Schatten der Künstlichen Intelligenz, München 2026, S. 7-10; Yuval Noah Harari, Homo Deus. Eine Geschichte von morgen. Aus dem Englischen übersetzt von Andreas Wirthensohn, Tb.-Ausg. München 2018, S. 528-533, S. 584-588; Roberto Simanowski, Sprachmaschinen. Eine Philosophie der Künstlichen Intelligenz, München 2025, S. 257f.
2 Vgl. exemplarisch Christian Götter, ›Künstliche Intelligenz‹ schreibt künstliche Geschichte. Ein Experiment zu OpenAIs ChatGPT im Geschichtsstudium, in: Geschichte in Wissenschaft und Unterricht 74 (2023), S. 312-324; Zeitschrift für Geschichtsdidaktik 24 (2025): Daten, Digitalität und historisches Lernen, hg. von Daniel Brandau und Sabrina Schmitz-Zerres; Patricia Wohner, Hausarbeiten mit einem Klick? KI und akademische Integrität in der Geschichtswissenschaft, Vortragsreihe VH|D|igital, 4.3.2026.
3 Vgl. Mareike König, ChatGPT und Co. in den Geschichtswissenschaften – Grundlagen, Prompts und Praxisbeispiele, in: Blog »Digital Humanities am DHIP«, 19.8.2024, aktualisiert am 29.9.2025; Torsten Hiltmann, Hermeneutik in Zeiten der KI. Large Language Models als hermeneutische Instrumente in den Geschichtswissenschaften, in: Gerhard Schreiber/Lukas Ohly (Hg.), KI:Text. Diskurse über KI-Textgeneratoren, Berlin 2024, S. 201-232; Mark Humphries, Building an AI Research Assistant, in: Generative History, 2.6.2023.
4 Zu dieser Debatte vgl. R. Darrell Meadows/Joshua Sternfeld, Artificial Intelligence and the Practice of History. A Forum, in: American Historical Review 128 (2023), S. 1345-1349; Wulf Kansteiner, Digital Doping for Historians. Can History, Memory, and Historical Theory be Rendered Artificially Intelligent?, in: History & Theory 61 (2022) H. 4, S. 119-133; Torsten Hiltmann, (Epistemologische) Grundlagen in der Anwendung digitaler Methoden, in: Christina Antenhofer/Christoph Kühberger/Arno Strohmeyer (Hg.), Digital Humanities in den Geschichtswissenschaften, Wien 2024, S. 43-60; Marnie Hughes-Warrington/Anne Martin/Lewis Yarlupurka OʼBrien, Artificial Historians, London 2026.
5 »Der aktuelle Prozess der Digitalisierung« wird dabei »in seiner Fundamentalität wie in seinen Konsequenzen« bereits mit den epochalen Auswirkungen der »Verschriftlichung« verglichen. Torsten Hiltmann, Vom Medienwandel zum Methodenwandel. Die fortschreitende Digitalisierung und ihre Konsequenzen für die Geschichtswissenschaften in historischer Perspektive, in: Karoline Döring u.a. (Hg.), Digital History. Konzepte, Methoden und Kritiken Digitaler Geschichtswissenschaft, Berlin 2022, S. 13-44, hier S. 22. Zur Bedeutung einer »Kulturtechnik digitaler Literalität« und den neuen Möglichkeiten der Mustererkennung in Massendaten vgl. auch Sybille Krämer, Der Stachel des Digitalen. Geisteswissenschaften und Digital Humanities, Berlin 2025.
6 »Geisteswissenschaften und Elektronenrechner«, konstatierte die »Historische Zeitschrift« 1968, muten zwar »gelegentlich noch wie eine morganatische Verbindung an«, doch werde sich das Fach der umwälzenden »Einwirkung« der neuen Technik alsbald kaum mehr »entziehen können«. Vgl. Carl August Lückerath, Prolegomena zur elektronischen Datenverarbeitung im Bereich der Geschichtswissenschaft, in: Historische Zeitschrift 207 (1968), S. 265-296, hier S. 265f. Der zur Annales-Schule zählende Emmanuel Le Roy Ladurie prognostizierte gar, der Historiker werde gänzlich verschwinden, wenn er sich nicht zum Programmierer ausbilden lasse. Vgl. La fin des érudits. L’historien de demain sera programmeur ou ne sera pas, in: Nouvel Observateur, 8.5.1968. Zur Diskussion über das Verhältnis von Clio und Computer seit den 1970er-Jahren vgl. Gerben Zaagsma, Facing the History Machine. Toward Histories of Digital History, in: History of Humanities 9 (2024), S. 451-491; Mareike König, Die digitale Transformation in den Geschichtswissenschaften, in: Antenhofer/Kühberger/Strohmeyer, Digital Humanities (Anm. 4), S. 19-42.
7 Ahasver von Brandt, Werkzeug des Historikers. Eine Einführung in die historischen Hilfswissenschaften, Stuttgart 1958, 18. Aufl. 2012; Winfried Baumgart, Bücherverzeichnis zur deutschen Geschichte. Hilfsmittel, Handbücher, Quellen, Frankfurt a.M. 1971, 18., überarb. und erweiterte Aufl. Stuttgart 2014.
8 Edgar F. Codd, A Relational Model of Data for Large Shared Data Banks, in: Communications of the ACM 13 (1970), S. 377-387, hier S. 377.
9 David Gugerli, Die Welt als Datenbank. Zur Relation von Softwareentwicklung, Abfragetechnik und Deutungsautonomie, in: Nach Feierabend. Zürcher Jahrbuch für Wissensgeschichte 3 (2007): Daten, hg. von David Gugerli u.a., S. 11-36, hier S. 17.
10 Vgl. Peter Burke, Die Explosion des Wissens. Von der Encyclopédie bis Wikipedia. Aus dem Englischen von Matthias Wolf unter Mitarbeit von Sebastian Wohlfeil, Berlin 2014; James W. Cortada, Building Blocks of Society. History, Information Ecosystems and Infrastructures, Lanham 2020; ders., Birth of Modern Facts. How the Information Revolution Transformed Academic Research, Governments, and Businesses, Lanham 2023.
11 In den 1950er- und 1960er-Jahren versuchte die Classification Research Group überdies der zunehmenden disziplinären Sprachverwirrung entgegenzuwirken und ein universales System der Wissensorganisation zu prägen. Vgl. Claudio Gnoli, Is an All-Purpose Classification Possible? Insights from Farradane’s Approach to Knowledge Organization, in: Synthese 205 (2025), Article 177.
12 Vgl. Karsten Schuldt, Automatisierung in Wissenschaftlichen Bibliotheken der 1960er Jahre: Der Anfang des Einsatzes von Computern in Bibliotheken im DACH-Raum, in: LIBREAS. Library Ideas 39 (2021).
13 J.C.R. Licklider, Libraries of the Future, Cambridge, Mass. 1965; Vannevar Bush, As We May Think, in: Atlantic Monthly 176 (1945), S. 101-108.
14 Licklider, Libraries (Anm. 13), S. 5.
15 Ebd.
16 Vgl. Thomas Baker, German Library Networks in the Web Age, in: Library Hi Tech 14 (1996) H. 4, S. 24-28; Hartmut Weber/Gerald Maier (Hg.), Digitale Archive und Bibliotheken. Neue Zugangsmöglichkeiten und Nutzungsqualitäten, Stuttgart 2000.
17 Für einen Überblick zur Geschichte von Fachdatenbanken vgl. Marcus Schröter, Historische Volltextdatenbanken, in: Silvia Daniel u.a. (Hg.), Clio Guide – Ein Handbuch zu digitalen Ressourcen für die Geschichtswissenschaften, 3., erweiterte und aktualisierte Aufl. Berlin 2023–2025.
18 Shoshana Zuboff, Das Zeitalter des Überwachungskapitalismus. Aus dem Englischen von Bernhard Schmid, Frankfurt a.M. 2018, S. 85-122. Der Ranking-Algorithmus richtete die Ergebnisse der Suche dabei an zusehends komplexen Relevanz- und Popularitätsmetriken aus. Vgl. dazu David Gugerli, Suchmaschinen. Die Welt als Datenbank, Frankfurt a.M. 2009; Thomas Brandstetter/Thomas Hübel/Anton Tantner (Hg.), Vor Google. Eine Mediengeschichte der Suchmaschine im analogen Zeitalter, Bielefeld 2012. Die Syntheseleistung blieb derweil auch im Zeitalter von Google & Co. den Suchenden vorbehalten.
19 Vgl. etwa Christian Götter, Künstliche Intelligenz und Geschichtswissenschaft. Mehr als ein neues Werkzeug für die Digital History?, in: Historische Zeitschrift 319 (2024), S. 299-330; Lina Franken, Von Wahrscheinlichkeiten und Aussagen. Kontextualisierungen künstlicher Intelligenz zwischen Ausprobieren und Reflektieren, in: Zeitschrift für Empirische Kulturwissenschaft 121 (2025), S. 276-278; Christoph Rass/Arbeitsgruppe Neueste Geschichte und Historische Migrationsforschung, KI und Geschichtswissenschaft. Eine Positionierung, Stand: Oktober 2026, URL: <https://www.uni-osnabrueck.de/fb1/geschichte/nghm/studium-lehre/digital-history/ki-und-geschichtswissenschaft-eine-positionierung>.
20 Zu den Möglichkeiten und Problemen generativer KI als Schreibwerkzeug vgl. u.a. Götter, Künstliche Intelligenz (Anm. 19), S. 322-325; Marnie Hughes-Warrington, Toward the Recognition of Artificial History Makers, in: History & Theory 61 (2022) H. 4, S. 107-118; Bill Wasik, A.I. Is Poised to Rewrite History. Literally, in: New York Times, 16.6.2025.
21 Bei einer Recherche zur Bedeutung der Weltwirtschaftskrise für das Erstarken des Nationalsozialismus listete ChatGPT (Modell GPT 5.5 Instant, 8.7.2026) etwa nur Monographien. Darauf hingewiesen, korrigierte sich das LLM dienstbeflissen und konstatierte nun, »dass die wichtigsten methodischen Innovationen der letzten zwanzig Jahre zunächst in Aufsatzform erschienen sind«. Beim Versuch, diese Forschungen einzuordnen, lag die KI dann aber, auch in Ermangelung digital zugänglicher Rechercheergebnisse, geradezu grotesk daneben und begann zu halluzinieren. Eine systematische Literaturrecherche, die sich über strukturierte (Meta-)Prompts und den Einsatz mehrerer LLMs absichert, kann zwar sehr gute Ergebnisse erzielen, setzt aber wiederum eine profunde Kenntnis der Wissensordnungen voraus, auf welche die LLMs zugreifen.
22 Prompts zur Digitalgeschichte bei Kimi K3; bessere Ergebnisse zeitigen die in Reihe geschalteten Modelle Gemini 3.5 Flash-Lite und Claude Sonnet 5, am 23.7.2026.
23 So ermittelte Claude Sonnet 5 in Sekundenschnelle korrekt, dass Erich Mende, Heinz Starke und Siegfried Zoglmann am 9. Oktober 1970 aus Protest gegen die politische Linie der sozialliberalen Regierungskoalition die Fraktion verließen. Auf genauere Nachfrage, ob das wirklich alle gewesen seien, erklärte die KI, dass es sich »um ein faszinierendes Thema« handele und 1972 auch Knut von Kühlmann-Stumm, Gerhard Kienbaum und Wilhelm Helms ausgetreten seien. Im Anschluss wurden die Motivlagen der Abtrünnigen näher beschrieben.
24 Die Bedeutung eines Wortes wie »Revolution« entsteht so erst im Moment seiner Einbettung in konkrete Kontexte, etwa politischer Umwälzungen oder technologischer Veränderungen, und wird im Prozess der Verwendung stets neu berechnet. Aus den Relationen ergeben sich dynamische Zustandsvektoren, wobei der Vektorraum durch komplexe Interpolationen zwischen Datenpunkten auch noch »wachsen« kann.
25 Zu den gesellschaftlichen und politischen Effekten gibt es inzwischen eine umfangreiche Literatur. Vgl. etwa Cathy O’Neil, Weapons of Math Destruction. How Big Data Increases Inequality and Threatens Democracy, New York 2016; Safiya U. Noble, Algorithms of Oppression. How Search Engines Reinforce Racism, New York 2018; Virginia Eubanks, Automating Inequality. How High-Tech Tools Profile, Police, and Punish the Poor, New York 2018; Wendy Hui Kyong Chun, Discriminating Data. Correlation, Neighborhoods, and the New Politics of Recognition, Cambridge, Mass. 2021; Katherine B. Forrest, When Machines Can Be Judge, Jury, and Executioner. Justice in the Age of Artificial Intelligence, New Jersey 2021; Jeanette Hofmann, Ohne Intelligenz[,] aber wirkmächtig. Künstliche Intelligenz als Akteur im öffentlichen Raum, in: Peter Dabrock u.a. (Hg.), Grenzen von Vermittlung – Vermittlung von Grenzen. Ethische, theologische und gesellschaftswissenschaftliche Erkundungen, Stuttgart 2025, S. 120-127.
26 Vgl. Michel Foucault, Die Ordnung der Dinge. Eine Archäologie der Humanwissenschaften. Aus dem Französischen von Ulrich Köppen, Frankfurt a.M. 2003, S. 17 (frz. Erstausg. 1966, dt. Erstausg. 1971).
27 Aus dieser Warte scheinen kleinere Sprachmodelle, die eine geringere Latenz, zugleich aber auch ein höheres Maß an domänenspezifischer Genauigkeit, an Datenkontrolle und -autonomie versprechen, an Bedeutung zu gewinnen. Vgl. dazu Michael Kwet, Digital Degrowth. Technology in the Age of Survival, London 2024; Neil Selwyn, Digital Degrowth. Radically Rethinking our Digital Futures, Cambridge 2025.
28 Der Kulturwissenschaftler und Medienphilosoph Roberto Simanowski sprach unlängst gar vom »Ende des Historikers«, dem in der Ära digitaler Quellensammlung bereits »das Ende der Archivarin« vorausgegangen sei. Vgl. Simanowski, Sprachmaschinen (Anm. 1), S. 100. Für eine historische Perspektivierung der aktuellen Entwicklungen im Bereich der Künstlichen Intelligenz vgl. derweil Rudolf Seising, Es denkt nicht! Die vergessenen Geschichten der KI, Frankfurt a.M. 2021; Martina Heßler, Sisyphos im Maschinenraum. Eine Geschichte der Fehlbarkeit von Mensch und Technologie, München 2025.
29 Benjamin Bratton, The Five Stages of AI Grief, in: Noema Magazine, 20.6.2024.
30 Die »tektonische Verschiebung der Wissensordnung« in Zeiten der KI sei daher »ein idealer Gegenstand intensiver fachübergreifender Selbstreflexion«, so unlängst etwa auch Claus Leggewie, Schneller, höher, weiter?, in: Frankfurter Allgemeine Zeitung, 7.10.2026, S. N4.
31 Kiran Tomlinson u.a., Working with AI. Measuring the Applicability of Generative AI to Occupations, in: arXiv, 10.7.2025 (und weitere Versionen).
32 Aus der aktuellen Auseinandersetzung über den Einsatz von KI mag so eine neue, produktive Debatte über die »Sehepunkte« und Positionalitäten der Forschenden – angesichts der scheinbar »neutral« argumentierenden KI und ihrer stochastischen »Wahrheit« – hervorgehen. Vgl. dazu Mads Pankow, Die wahrscheinliche Wahrheit. Wie KI unsere Wirklichkeit, Moral und Gesellschaft neu berechnet, Berlin 2026, S. 92-127.
33 Johann Gustav Droysen, Grundriß der Historik (1856/57 und 1882), in: Wolfgang Hardtwig (Hg.), Über das Studium der Geschichte, München 1990, S. 83-117, hier S. 91. Vgl. auch Götter, Künstliche Intelligenz (Anm. 19), S. 312 und passim.
34 Zur Bedeutung von Überlieferung und Tradition im Prozess des historischen Verstehens siehe klassisch: Hans-Georg Gadamer, Wahrheit und Methode. Grundzüge einer philosophischen Hermeneutik, Tübingen 1960, 6. Aufl. 1990 (Gesammelte Werke, Bd. 1).
35 Donald Davidson, On the Very Idea of a Conceptual Scheme, in: Proceedings and Addresses of the American Philosophical Association 47 (1973/74), S. 5-20, hier S. 19: »[…] we improve the clarity and bite of declarations of difference, whether of scheme or opinion, by enlarging the basis of shared (translatable) language or of shared opinion.«
36 Zur Bedeutung der Algorithmen, die »einerseits neue Abhängigkeiten« kreieren, »indem sie die (informationelle) Welt vorsortieren und zugänglich machen«, und »andererseits für Autonomie [sorgen], indem sie die Voraussetzungen der persönlichen Handlungsfähigkeit schaffen«, vgl. auch Felix Stalder, Grundformen der Digitalität, in: agora42 Nr. 2/2017, S. 24-28, hier S. 28; ders., Kultur der Digitalität, Berlin 2016; Mercedes Bunz, Die stille Revolution. Wie Algorithmen Wissen, Arbeit, Öffentlichkeit und Politik verändern, ohne dabei viel Lärm zu machen, Berlin 2012; Elena Esposito, Artificial Communication. How Algorithms Produce Social Intelligence, Cambridge, Mass. 2022; Carl Friedrich Gethmann u.a., Künstliche Intelligenz in der Forschung. Neue Möglichkeiten und Herausforderungen für die Wissenschaft, Berlin 2022, S. 104-115.
37 Für eine Archäologie der Fantasien eines »Künstlichen Staates« ab der Mitte des 20. Jahrhunderts vgl. Jill Lepore, Die Regierung der Maschinen. Aufstieg und Fall des Künstlichen Staates. Aus dem Englischen übersetzt von Werner Roller und Annabel Zettel, München 2026, insbes. S. 12, S. 303-305.
38 Zur Diskussion um eine digitale Hermeneutik und eine neue Form der »Datenkritik« vgl. Andreas Fickers, Update für die Hermeneutik. Geschichtswissenschaft auf dem Weg zur digitalen Forensik?, in: Zeithistorische Forschungen/Studies in Contemporary History 17 (2020), S. 157-168, hier S. 158; ders./Juliane Tatarinov (Hg.), Digital History and Hermeneutics. Between Theory and Practice, Berlin 2022; Döring u.a., Digital History (Anm. 5); Stephen Ramsay, On the Digital Humanities. Essays and Provocations, Minneapolis 2023, S. 15-52.
39 Vgl. Kate Crawford, Atlas of AI. Power, Politics, and the Planetary Costs of Artificial Intelligence, New Haven 2021; Nathan Ensmenger, The Cloud Is a Factory, in: Thomas S. Mullaney u.a. (Hg.), Your Computer Is on Fire, Cambridge, Mass. 2021, S. 29-50. Zu den politischen und ökologischen Fallstricken des digitalen Wachstumskurses vgl. außerdem Michael Kwet, Digital Colonialism. US Empire and the New Imperialism in the Global South, in: Race & Class 60 (2019) H. 4, S. 3-26; Nick Couldry/Ulises A. Mejias, Data Grab. The New Colonialism of Big Tech and How to Fight Back, Chicago 2024; Selwyn, Digital Degrowth (Anm. 27).
40 Jürgen Habermas, Ein neuer Strukturwandel der Öffentlichkeit und die deliberative Politik, Berlin 2022; Farhad Manjoo, How 5 Tech Giants Have Become More Like Governments Than Companies, in: NPR, 26.10.2017; Athanasios Karafillidis, Containment eines Laborunfalls. Über die Regulierung Künstlicher Intelligenz, in: Merkur 80 (2026) H. 4, S. 36-47.